[TOC]
一、数据类型#
基本类型#
| 基本类型 | 大小 | 最小值 | 最大值 | 默认值 | 包装器类型 |
|---|---|---|---|---|---|
| boolean | - | - | - | false | Boolean |
| byte | 8 | -128 | 127 | (byte)0 | Byte |
| char | 16 | Unicode 0 | Unicode 65535 | \u0000 | Character |
| short | 16 | -32768 | 32767 | (short)0 | Short |
| int | 32 | -231 | 231-1 | 0 | Integer、BigInteger |
| long | 64 | -263 | 263-1 | 0L | Long |
| float | 32 | IEEE754 | IEEE754 | 0.0f | Float、BigDecimal |
| double | 64 | IEEE754 | IEEE754 | 0.0d, 0.0 | Double |
boolean 只有两个值:true、false,可以使用 1 bit 来存储,但是具体大小没有明确规定。JVM 会在编译时期将 boolean 类型的数据转换为 int,使用 1 来表示 true,0 表示 false。JVM 支持 boolean 数组,但通过读写 byte 数组来实现的。
char (采用UTF-16LE编码Unicode字符)中只能放 UTF-16 编码下只占 2 字节的那些字符
包装类型#
基本类型都有对应的包装类型,基本类型与其对应的包装类型之间的赋值使用自动装箱与拆箱完成。包装类型是不可变对象!
Integer x = 2;     // 装箱 调用了 Integer.valueOf(2)
int y = x;         // 拆箱 调用了 X.intValue()
++x; // 先拆箱,在自增,最后在装箱,注意:操作完成后,x将引用另外一个Integer对象缓存池#
new Integer(123) 与 Integer.valueOf(123) 的区别在于:
- new Integer(123) 每次都会新建一个对象;
- Integer.valueOf(123) 会使用缓存池中的对象,多次调用会取得同一个对象的引用。
Integer x = new Integer(123);
Integer y = new Integer(123);
System.out.println(x == y);    // false
Integer z = Integer.valueOf(123);
Integer k = Integer.valueOf(123);
System.out.println(z == k);   // true
valueOf() 方法的实现比较简单,就是先判断值是否在缓存池中,如果在的话就直接返回缓存池的内容。
public static Integer valueOf(int i) {
    if (i >= IntegerCache.low && i <= IntegerCache.high)
        return IntegerCache.cache[i + (-IntegerCache.low)];
    return new Integer(i);
}
在 Java 8 中,Integer 缓存池的大小默认为 -128~127。
static final int low = -128;
static final int high;
static final Integer cache[];

static {
    // high value may be configured by property
    int h = 127;
    String integerCacheHighPropValue =
        sun.misc.VM.getSavedProperty("java.lang.Integer.IntegerCache.high");
    if (integerCacheHighPropValue != null) {
        try {
            int i = parseInt(integerCacheHighPropValue);
            i = Math.max(i, 127);
            // Maximum array size is Integer.MAX_VALUE
            h = Math.min(i, Integer.MAX_VALUE - (-low) -1);
        } catch( NumberFormatException nfe) {
            // If the property cannot be parsed into an int, ignore it.
        }
    }
    high = h;

    cache = new Integer[(high - low) + 1];
    int j = low;
    for(int k = 0; k < cache.length; k++)
        cache[k] = new Integer(j++);

    // range [-128, 127] must be interned (JLS7 5.1.7)
    assert IntegerCache.high >= 127;
}
编译器会在自动装箱过程调用 valueOf() 方法,因此多个值相同且值在缓存池范围内的 Integer 实例使用自动装箱来创建,那么就会引用相同的对象。
Integer m = 123;
Integer n = 123;
System.out.println(m == n); // true
基本类型对应的缓冲池如下:
- boolean values true and false
- all byte values
- short values between -128 and 127
- int values between -128 and 127
- char in the range \u0000 to \u007F
在使用这些基本类型对应的包装类型时,如果该数值范围在缓冲池范围内,就可以直接使用缓冲池中的对象。
在 jdk 1.8 所有的数值类缓冲池中,Integer 的缓冲池 IntegerCache 很特殊,这个缓冲池的下界是 - 128,上界默认是 127,但是这个上界是可调的,在启动 jvm 的时候,通过 -XX:AutoBoxCacheMax=<size> 来指定这个缓冲池的大小,该选项在 JVM 初始化的时候会设定一个名为 java.lang.IntegerCache.high 系统属性,然后 IntegerCache 初始化的时候就会读取该系统属性来决定上界。
StackOverflow : Differences between new Integer(123), Integer.valueOf(123) and just 123
参数传递#
方法类型:签名由
Java 的参数是以值传递的形式传入方法中,而不是引用传递。
以下代码中 Dog dog 的 dog 是一个指针,存储的是对象的地址。在将一个参数传入一个方法时,本质上是将对象的地址以值的方式传递到形参中。
public class Dog {

    String name;

    Dog(String name) {
        this.name = name;
    }

    String getName() {
        return this.name;
    }

    void setName(String name) {
        this.name = name;
    }

    String getObjectAddress() {
        return super.toString();
    }
}
在方法中改变对象的字段值会改变原对象该字段值,因为引用的是同一个对象。
class PassByValueExample {
    public static void main(String[] args) {
        Dog dog = new Dog("A");
        func(dog);
        System.out.println(dog.getName());          // B
    }

    private static void func(Dog dog) {
        dog.setName("B");
    }
}
但是在方法中将指针引用了其它对象,那么此时方法里和方法外的两个指针指向了不同的对象,在一个指针改变其所指向对象的内容对另一个指针所指向的对象没有影响。
public class PassByValueExample {
    public static void main(String[] args) {
        Dog dog = new Dog("A");
        System.out.println(dog.getObjectAddress()); // Dog@4554617c
        func(dog);
        System.out.println(dog.getObjectAddress()); // Dog@4554617c
        System.out.println(dog.getName());          // A
    }

    private static void func(Dog dog) {
        System.out.println(dog.getObjectAddress()); // Dog@4554617c
        dog = new Dog("B");
        System.out.println(dog.getObjectAddress()); // Dog@74a14482
        System.out.println(dog.getName());          // B
    }
}
StackOverflow: Is Java “pass-by-reference” or “pass-by-value”?
类型转换#
强制类型转换:显式向下转型 (SubClass)baseRef
,其正确性由Run-Time Type Identification`机制保证自动类型转换:Java 仅支持隐式向上转型,不能隐式执行向下转型,因为这会使得精度降低。但有一个例外:

TODO: 自动包装
TODO: toString()自动类型转换
因为字面量 1 是 int 类型,它比 short 类型精度要高,因此不能隐式地将 int 类型向下转型为 short 类型。
short s1 = 1;
//! s1 = s1 + 1;
但是使用 += 或者 ++ 运算符会执行隐式类型转换。
s1 += 1;
s1++;
上面的语句相当于将 s1 + 1 的计算结果进行了显式向下转型:
s1 = (short) (s1 + 1);StackOverflow : Why don’t Java’s +=, -=, *=, /= compound assignment operators require casting?
类对象初始化#
- new 分配对象空间,并执行成员变量默认初始化
- 执行成员变量显式初始化
- 调用构造方法:调用构造器之前,所有数据成员按定义顺序依次初始化
- 返回对象地址
二、String#
字符集与编码#
| 字符集 | 编号(code point) | 编码(encoding) | 用途 | BOM |
|---|---|---|---|---|
| 拉丁字母 | ASCII | ASCII | ||
| 简体中文 | GB2312 | GB2312 | ||
| 所有字符 | Unicode | UTF-8 | 变长,兼容ASCII、适合存储、传输 | EFBBBF(统一用大端BE) |
| 使用代理区表示Unicode字符 | 0x10FFFF | UTF-16 | **定长,**省空间、用于内存表示 | FEFF(BE)、FFFE(LE) |
| 使用4字节表示Unicode字符 | Unicode | UTF-32 | 直观表示所有Unicode,但浪费空间 | \uFEFF |
- 字符、Unicode、UTF-8、UTF-16、UTF-32相互编码和解码。一次可连续输入64个字符;编码也是连续输入,但需注意UTF-16/32的字节顺序标记(BOM),如果没有提供BOM,默认以大尾序解码。
- Unicode 是容纳世界所有文字符号的国际标准编码,使用四个字节为每个字符编码。
- UTF 是英文 Unicode Transformation Format 的缩写,意为把 Unicode 字符转换为某种格式。UTF 系列编码方案(UTF-8、UTF-16、UTF-32)均是由 Unicode 编码方案衍变而来,以适应不同的数据存储或传递,它们都可以完全表示 Unicode 标准中的所有字符。目前,这些衍变方案中 UTF-8 被广泛使用,而 UTF-16 和 UTF-32 则很少被使用。
- UTF-8 使用一至四个字节为每个字符编码,其中大部分汉字采用三个字节编码,少量不常用汉字采用四个字节编码。因为 UTF-8 是可变长度的编码方式,相对于 Unicode 编码可以减少存储占用的空间,所以被广泛使用。
- UTF-16 使用二或四个字节为每个字符编码,其中大部分汉字采用两个字节编码,少量不常用汉字采用四个字节编码。UTF-16 编码有大尾序和小尾序之别,即 UTF-16BE 和 UTF-16LE,在编码前会放置一个 U+FEFF 或 U+FFFE(UTF-16BE 以 FEFF 代表,UTF-16LE 以 FFFE 代表),其中 U+FEFF 字符在 Unicode 中代表的意义是 ZERO WIDTH NO-BREAK SPACE,顾名思义,它是个没有宽度也没有断字的空白。
- UTF-32 使用四个字节为每个字符编码,使得 UTF-32 占用空间通常会是其它编码的二到四倍。UTF-32 与 UTF-16 一样有大尾序和小尾序之别,编码前会放置 U+0000FEFF 或 U+FFFE0000 以区分。
- 字符集与编码(四)——Unicode
概览#
String 被声明为 final,因此它不可被继承。(Integer 等包装类也不能被继承)
在 Java 8 中,String 内部使用 char 数组存储数据。
public final class String
    implements java.io.Serializable, Comparable<String>, CharSequence {
    /** The value is used for character storage. */
    private final char value[];
}
在 Java 9 之后,String 类的实现改用 byte 数组存储字符串,同时使用 coder 来标识使用了哪种编码。
public final class String
    implements java.io.Serializable, Comparable<String>, CharSequence {
    /** The value is used for character storage. */
    private final byte[] value;

    /** The identifier of the encoding used to encode the bytes in {@code value}. */
    private final byte coder;
}
value 数组被声明为 final,这意味着 value 数组初始化之后就不能再引用其它数组。并且 String 内部没有改变 value 数组的方法,因此可以保证 String 不可变。
不可变的好处#
1. 可以缓存 hash 值
因为 String 的 hash 值经常被使用,例如 String 用做 HashMap 的 key。不可变的特性可以使得 hash 值也不可变,因此只需要进行一次计算。
2. String Pool 的需要
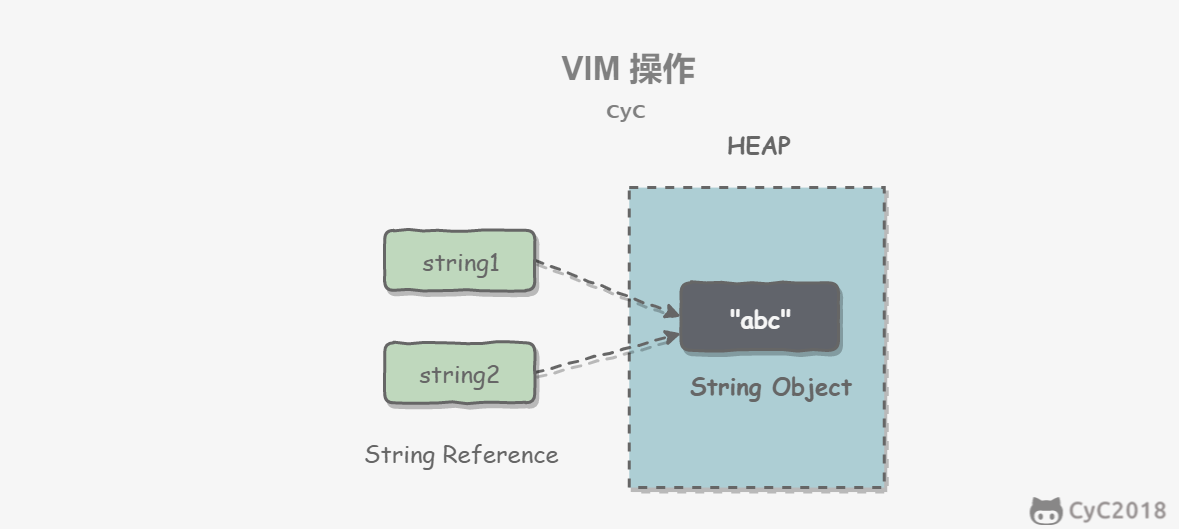
如果一个 String 对象已经被创建过了,那么就会从 String Pool 中取得引用。只有 String 是不可变的,才可能使用 String Pool。
3. 安全性
String 经常作为参数,String 不可变性可以保证参数不可变。例如在作为网络连接参数的情况下如果 String 是可变的,那么在网络连接过程中,String 被改变,改变 String 的那一方以为现在连接的是其它主机,而实际情况却不一定是。
4. 线程安全
String 不可变性天生具备线程安全,可以在多个线程中安全地使用。
Program Creek : Why String is immutable in Java?
String, StringBuffer and StringBuilder#
1. 可变性
- String 不可变
- StringBuffer 和 StringBuilder 可变
2. 线程安全
- String 不可变,因此是线程安全的
- StringBuilder 线程不安全,但是效率高
- StringBuffer 是线程安全的,内部使用 synchronized 进行同步
StackOverflow : String, StringBuffer, and StringBuilder
String Pool#
字符串常量池(String Pool)保存着所有字符串字面量(literal strings),这些字面量在编译时期就确定。不仅如此,还可以使用 String 的 intern() 方法在运行过程将字符串添加到 String Pool 中。
当一个字符串调用 intern() 方法时,如果 String Pool 中已经存在一个字符串和该字符串值相等(使用 equals() 方法进行确定),那么就会返回 String Pool 中字符串的引用;否则,就会在 String Pool 中添加一个新的字符串,并返回这个新字符串的引用。
下面示例中,s1 和 s2 采用 new String() 的方式新建了两个不同字符串,而 s3 和 s4 是通过 s1.intern() 方法取得同一个字符串引用。intern() 首先把 s1 引用的字符串放到 String Pool 中,然后返回这个字符串引用。因此 s3 和 s4 引用的是同一个字符串。
String s1 = new String("aaa");
String s2 = new String("aaa");
System.out.println(s1 == s2);           // false
String s3 = s1.intern();
String s4 = s1.intern();
System.out.println(s3 == s4);           // true
如果是采用 “bbb” 这种字面量的形式创建字符串,会自动地将字符串放入 String Pool 中。
String s5 = "bbb";
String s6 = "bbb";
System.out.println(s5 == s6);  // true
在 Java 7 之前,String Pool 被放在运行时常量池中,它属于永久代。而在 Java 7,String Pool 被移到堆中。这是因为永久代的空间有限,在大量使用字符串的场景下会导致 OutOfMemoryError 错误。
new String(“abc”)#
使用这种方式一共会创建两个字符串对象(前提是 String Pool 中还没有 “abc” 字符串对象)。
- “abc” 属于字符串字面量,因此编译时期会在 String Pool 中创建一个字符串对象,指向这个 “abc” 字符串字面量;
- 而使用 new 的方式会在堆中创建一个字符串对象。
创建一个测试类,其 main 方法中使用这种方式来创建字符串对象。
public class NewStringTest {
    public static void main(String[] args) {
        String s = new String("abc");
    }
}
使用 javap -verbose 进行反编译,得到以下内容:
// ...
Constant pool:
// ...
   #2 = Class              #18            // java/lang/String
   #3 = String             #19            // abc
// ...
  #18 = Utf8               java/lang/String
  #19 = Utf8               abc
// ...

  public static void main(java.lang.String[]);
    descriptor: ([Ljava/lang/String;)V
    flags: ACC_PUBLIC, ACC_STATIC
    Code:
      stack=3, locals=2, args_size=1
         0: new           #2                  // class java/lang/String
         3: dup
         4: ldc           #3                  // String abc
         6: invokespecial #4                  // Method java/lang/String."<init>":(Ljava/lang/String;)V
         9: astore_1
// ...
在 Constant Pool 中,#19 存储这字符串字面量 “abc”,#3 是 String Pool 的字符串对象,它指向 #19 这个字符串字面量。在 main 方法中,0: 行使用 new #2 在堆中创建一个字符串对象,并且使用 ldc #3 将 String Pool 中的字符串对象作为 String 构造函数的参数。
以下是 String 构造函数的源码,可以看到,在将一个字符串对象作为另一个字符串对象的构造函数参数时,并不会完全复制 value 数组内容,而是都会指向同一个 value 数组。
public String(String original) {
    this.value = original.value;
    this.hash = original.hash;
}格式化输出#
System.out.printf("格式说明符", var1, var2...);
System.out.format("格式说明符", var1, var2...);
格式说明符 %[arguementIndex$][flags][width][.precision]conversion
arguementIndex$:参数占位符flags:对齐控制,默认右对齐,-为左对齐width:控制域最小尺寸.precision:控制域最大尺寸,不能用于整型conversion:格式转换
| conversion | meaning |
|---|---|
| d | 十进制整数 |
| x | 十六进制整数 |
| h | 十六进制hash值 |
| % | % |
| f | 十进制浮点数 |
| e | 科学技术浮点数 |
| b | boolean值 |
| c | Unicode字符 |
| s | 字符串 |
正则表达式#
三、时间相关类#

long now = System.currentTimeMillis();
Date date = new Date(now);                 // 精确到毫秒

DateFormat df = new SimpleDateFormat("yyyy-MM-dd hh:mm:ss")
String daytime = df.format(date);
Date date = df.parse("2007-10-7 20:15:30")

Calendar calendar = new GregorianCalendar();
四、关键字#
switch#
从 Java 7 开始,可以在 switch 条件判断语句中使用 String 对象。
String s = "a";
switch (s) {
    case "a":
        System.out.println("aaa");
        break;
    case "b":
        System.out.println("bbb");
        break;
}
switch 不支持 long,是因为 switch 的设计初衷是对那些只有少数几个值的类型进行等值判断,如果值过于复杂,那么还是用 if 比较合适。
// long x = 111;
// switch (x) { // Incompatible types. Found: 'long', required: 'char, byte, short, int, Character, Byte, Short, Integer, String, or an enum'
//     case 111:
//         System.out.println(111);
//         break;
//     case 222:
//         System.out.println(222);
//         break;
// }
StackOverflow : Why can’t your switch statement data type be long, Java?
final#
1. 数据
声明数据为常量,可以是编译时常量,也可以是在运行时(用一个方法赋值、构造方法内赋值)被初始化后不能被改变的常量。
- 对于基本类型,final 使数值不变;
- 对于引用类型,final 使引用不变,也就不能引用其它对象,但是被引用的对象本身是可以修改的。
final int x = 1;
// x = 2;  // cannot assign value to final variable 'x'
final A y = new A();
y.a = 1;
2. 方法
声明方法不能被子类重写,只能继承。
private 方法隐式地被指定为 final,如果在子类中定义的方法和基类中的一个 private 方法签名相同,此时子类的方法不是重写基类方法,而是在子类中定义了一个新的方法。
3. 类
声明类不允许被继承。
static#
1. 静态变量
- 静态变量:又称为类变量,也就是说这个变量属于类的,类所有的实例都共享静态变量,可以直接通过类名来访问它。静态变量在内存中只存在一份。
- 实例变量:每创建一个实例就会产生一个实例变量,它与该实例同生共死。
public class A {

    private int x;         // 实例变量
    private static int y;  // 静态变量

    public static void main(String[] args) {
        // int x = A.x;  // Non-static field 'x' cannot be referenced from a static context
        A a = new A();
        int x = a.x;
        int y = A.y;
    }
}
2. 静态方法
静态方法在类加载的时候就存在了,它不依赖于任何实例。所以静态方法必须有实现,也就是说它不能是抽象方法。
public abstract class A {
    public static void func1(){
    }

    // Illegal combination of modifiers: 'abstract' and 'static'
    // public abstract static void func2();
}
只能访问所属类的静态字段和静态方法,方法中不能有 this 和 super 关键字,因此这两个关键字与具体对象关联;也不能直接调用非静态方法。
public class A {

    private static int x;
    private int y;

    public static void func1(){
        int a = x;
        // int b = y;  // Non-static field 'y' cannot be referenced from a static context
        // int b = this.y;     // 'A.this' cannot be referenced from a static context
    }
}
3. 静态语句块
静态语句块在类初始化时运行一次。
public class A {
    static {
        System.out.println("123");
    }

    public static void main(String[] args) {
        A a1 = new A();
        A a2 = new A();
    }
}1234. 静态内部类
非静态内部类依赖于外部类的实例,也就是说需要先创建外部类实例,才能用这个实例去创建非静态内部类。而静态内部类不需要。
public class OuterClass {

    class InnerClass {
    }

    static class StaticInnerClass {
    }

    public static void main(String[] args) {
        // InnerClass innerClass = new InnerClass(); // 'OuterClass.this' cannot be referenced from a static context
        OuterClass outerClass = new OuterClass();
        InnerClass innerClass = outerClass.new InnerClass();
        StaticInnerClass staticInnerClass = new StaticInnerClass();
    }
}
静态内部类不能访问外部类的非静态的变量和方法。
5. 静态导包
在使用静态变量和方法时不用再指明 ClassName,从而简化代码,但可读性大大降低。
import static com.xxx.ClassName.*6. 初始化顺序
静态变量和静态语句块优先于实例变量和普通语句块,静态变量和静态语句块的初始化顺序取决于它们在代码中的顺序。
public static String staticField = "静态变量";static {
System.out.println("静态语句块");
}public String field = "实例变量";{
System.out.println("普通语句块");
} // 可在此语句块内进行实例初始化最后才是构造函数的初始化。
public InitialOrderTest() {
    System.out.println("构造函数");
}
存在继承的情况下,初始化顺序为:
- 父类(静态变量、静态语句块)
//初次访问类中静态成员加载类,同时进行static初始 - 子类(静态变量、静态语句块)
// 静态块在类加载时执行 - 父类(实例变量、普通语句块)
//创建类实例时 - 父类(构造函数)
- 子类(实例变量、普通语句块)
- 子类(构造函数)
五、Object 通用方法#
概览#
public native int hashCode()

public boolean equals(Object obj)

protected native Object clone() throws CloneNotSupportedException

public String toString()

public final native Class<?> getClass()

protected void finalize() throws Throwable {}

public final native void notify()

public final native void notifyAll()

public final native void wait(long timeout) throws InterruptedException

public final void wait(long timeout, int nanos) throws InterruptedException

public final void wait() throws InterruptedExceptionequals()#
1. 等价关系
两个对象具有等价关系,需要满足以下五个条件:
Ⅰ 自反性
x.equals(x); // trueⅡ 对称性
x.equals(y) == y.equals(x); // trueⅢ 传递性
if (x.equals(y) && y.equals(z))
    x.equals(z); // true;
Ⅳ 一致性
多次调用 equals() 方法结果不变
x.equals(y) == x.equals(y); // trueⅤ 与 null 的比较
对任何不是 null 的对象 x 调用 x.equals(null) 结果都为 false
x.equals(null); // false;2. 等价与相等
- 对于基本类型,== 判断两个值是否相等,基本类型没有 equals() 方法。
- 对于引用类型,== 判断两个变量是否引用同一个对象,而 equals() 判断引用的对象是否等价。
Integer x = new Integer(1);
Integer y = new Integer(1);
System.out.println(x.equals(y)); // true
System.out.println(x == y);      // false
3. 实现
- 检查是否为同一个对象的引用,如果是直接返回 true;
- 检查是否是同一个类型,如果不是,直接返回 false;
- 将 Object 对象进行转型;
- 判断每个关键域是否相等。
public class EqualExample {

    private int x;
    private int y;
    private int z;

    public EqualExample(int x, int y, int z) {
        this.x = x;
        this.y = y;
        this.z = z;
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;

        EqualExample that = (EqualExample) o;

        if (x != that.x) return false;
        if (y != that.y) return false;
        return z == that.z;
    }
}hashCode()#
hashCode() 返回哈希值,而 equals() 是用来判断两个对象是否等价。等价的两个对象散列值一定相同,但是散列值相同的两个对象不一定等价,这是因为计算哈希值具有随机性,两个值不同的对象可能计算出相同的哈希值。
在覆盖 equals() 方法时应当总是覆盖 hashCode() 方法,保证等价的两个对象哈希值也相等。
HashSet 和 HashMap 等集合类使用了 hashCode() 方法来计算对象应该存储的位置,因此要将对象添加到这些集合类中,需要让对应的类实现 hashCode() 方法。
下面的代码中,新建了两个等价的对象,并将它们添加到 HashSet 中。我们希望将这两个对象当成一样的,只在集合中添加一个对象。但是 EqualExample 没有实现 hashCode() 方法,因此这两个对象的哈希值是不同的,最终导致集合添加了两个等价的对象。
EqualExample e1 = new EqualExample(1, 1, 1);
EqualExample e2 = new EqualExample(1, 1, 1);
System.out.println(e1.equals(e2)); // true
HashSet<EqualExample> set = new HashSet<>();
set.add(e1);
set.add(e2);
System.out.println(set.size());   // 2
理想的哈希函数应当具有均匀性,即不相等的对象应当均匀分布到所有可能的哈希值上。这就要求了哈希函数要把所有域的值都考虑进来。可以将每个域都当成 R 进制的某一位,然后组成一个 R 进制的整数。
R 一般取 31,因为它是一个奇素数,如果是偶数的话,当出现乘法溢出,信息就会丢失,因为与 2 相乘相当于向左移一位,最左边的位丢失。并且一个数与 31 相乘可以转换成移位和减法:31*x == (x<<5)-x,编译器会自动进行这个优化。
@Override
public int hashCode() {
    int result = 17;
    result = 31 * result + x;
    result = 31 * result + y;
    result = 31 * result + z;
    return result;
}toString()#
支持任何类向string的转换
默认返回 ToStringExample@4554617c 这种形式,其中 @ 后面的数值为散列码的无符号十六进制表示。
public class ToStringExample {

    private int number;

    public ToStringExample(int number) {
        this.number = number;
    }
}
ToStringExample example = new ToStringExample(123);
System.out.println(example.toString());ToStringExample@4554617cclone()#
1. cloneable
clone() 是 Object 的 protected 方法,它不是 public,一个类不显式去重写 clone(),其它类就不能直接去调用该类实例的 clone() 方法。
public class CloneExample {
    private int a;
    private int b;
}
CloneExample e1 = new CloneExample();
// CloneExample e2 = e1.clone(); // 'clone()' has protected access in 'java.lang.Object'重写 clone() 得到以下实现:
public class CloneExample {
    private int a;
    private int b;

    @Override
    public CloneExample clone() throws CloneNotSupportedException {
        return (CloneExample)super.clone();
    }
}
CloneExample e1 = new CloneExample();
try {
CloneExample e2 = e1.clone();
} catch (CloneNotSupportedException e) {
e.printStackTrace();
}java.lang.CloneNotSupportedException: CloneExample以上抛出了 CloneNotSupportedException,这是因为 CloneExample 没有实现 Cloneable 接口。
应该注意的是,clone() 方法并不是 Cloneable 接口的方法,而是 Object 的一个 protected 方法。Cloneable 接口只是规定,如果一个类没有实现 Cloneable 接口又调用了 clone() 方法,就会抛出 CloneNotSupportedException。
public class CloneExample implements Cloneable {
    private int a;
    private int b;

    @Override
    public Object clone() throws CloneNotSupportedException {
        return super.clone();
    }
}
2. 浅拷贝
拷贝对象和原始对象的引用类型引用同一个对象。
public class ShallowCloneExample implements Cloneable {

    private int[] arr;

    public ShallowCloneExample() {
        arr = new int[10];
        for (int i = 0; i < arr.length; i++) {
            arr[i] = i;
        }
    }

    public void set(int index, int value) {
        arr[index] = value;
    }

    public int get(int index) {
        return arr[index];
    }

    @Override
    protected ShallowCloneExample clone() throws CloneNotSupportedException {
        return (ShallowCloneExample) super.clone();
    }
}
ShallowCloneExample e1 = new ShallowCloneExample();
ShallowCloneExample e2 = null;
try {
e2 = e1.clone();
} catch (CloneNotSupportedException e) {
e.printStackTrace();
}
e1.set(2, 222);
System.out.println(e2.get(2)); // 2223. 深拷贝
拷贝对象和原始对象的引用类型引用不同对象。
public class DeepCloneExample implements Cloneable {

    private int[] arr;

    public DeepCloneExample() {
        arr = new int[10];
        for (int i = 0; i < arr.length; i++) {
            arr[i] = i;
        }
    }

    public void set(int index, int value) {
        arr[index] = value;
    }

    public int get(int index) {
        return arr[index];
    }

    @Override
    protected DeepCloneExample clone() throws CloneNotSupportedException {
        DeepCloneExample result = (DeepCloneExample) super.clone();
        result.arr = new int[arr.length];
        for (int i = 0; i < arr.length; i++) {
            result.arr[i] = arr[i];
        }
        return result;
    }
}
DeepCloneExample e1 = new DeepCloneExample();
DeepCloneExample e2 = null;
try {
e2 = e1.clone();
} catch (CloneNotSupportedException e) {
e.printStackTrace();
}
e1.set(2, 222);
System.out.println(e2.get(2)); // 24. clone() 的替代方案
使用 clone() 方法来拷贝一个对象即复杂又有风险,它会抛出异常,并且还需要类型转换。Effective Java 书上讲到,最好不要去使用 clone(),可以使用拷贝构造函数或者拷贝工厂来拷贝一个对象。
public class CloneConstructorExample {

    private int[] arr;

    public CloneConstructorExample() {
        arr = new int[10];
        for (int i = 0; i < arr.length; i++) {
            arr[i] = i;
        }
    }

    public CloneConstructorExample(CloneConstructorExample original) {
        arr = new int[original.arr.length];
        for (int i = 0; i < original.arr.length; i++) {
            arr[i] = original.arr[i];
        }
    }

    public void set(int index, int value) {
        arr[index] = value;
    }

    public int get(int index) {
        return arr[index];
    }
}
CloneConstructorExample e1 = new CloneConstructorExample();
CloneConstructorExample e2 = new CloneConstructorExample(e1);
e1.set(2, 222);
System.out.println(e2.get(2)); // 2finalize()#
finalize、垃圾回收机制、
System.gc()、引用计数、stop-and-copy停止复制、复制式回收器、自适应分代的、标记-清扫(mark-and-sweep)、即时编译器(JIT)
六、面向对象#
OOP概念#
- 数据抽象与封装:
- 创建新的数据类型:将数据与方法包装进类
- 用权限控制隐藏具体实现:接口与实现分离、防止用户误改内部机制
- 复用类:
- 继承:is a,复用接口,通过覆盖方法表达行为差异
- 组合:has a,使用对象,用字段表达状态上的变化
- 优先使用组合
- 多态:
- 动态绑定,消除类型耦合关系,使程序可拓展
- 分离做什么与怎么做,将接口与实现分离
- 改善代码结构和可读性
- 绑定:将一个方法调用与方法主体关联(符号引用–>直接引用)
- 前期/静态绑定:程序执行前由编译器或链接程序实现绑定,静态方法、私有方法(子类不可见,隐含final语义,因此不可被继承,就不是虚方法),实例构造方法(不可被继承);此类方法编译器可知,在编译期完成绑定(符号引用–>直接引用),运行期不可改变。
- 后期/动态绑定:运行时根据对象类型进行绑定,
Java中对域的访问都是在编译器进行静态绑定的,除了final、static方法外均采用动态绑定,我们称运行期间将符号引用转化为直接引用的方法为虚方法。
- 设计模式
类文件组织#
- 编译单元:
ClassName.java- 每个
.java文件内最多能有一个public类,且该类必须与文件同名 - 文件内其他类在包内可见,仅用来为主
public类提供支持 .java文件经编译生成对应的.class文件
- 每个
- 类库单元:
package- 包名须使用小写字母
- 包(类库)实质是一组类文件
package须出现在文件起始处import可使包内名称在包外可用- 默认包:若
.java文件未明确设定包名称,则其默认隶属与其目录的默认包中
- 文件组织
- 创建一个独一无二的包名:
domain.package - 查找隐藏于目录结构中的某处的类:将包名分解为机器上的一个目录,并将属于该包的所有
.class文件置于该目录下
- 创建一个独一无二的包名:
访问权限#
Java 中有四种访问权限:private、default(默认包访问权限package)、protected 以及 public。
可以对类或类中的成员(字段和方法)加上访问修饰符。
- 类可见表示其它类可以用这个类创建实例对象。
- 成员可见表示其它类可以用这个类的实例对象访问到该成员;
protected 用于修饰成员,表示在继承体系中成员对于子类可见,但是这个访问修饰符对于类没有意义。
设计良好的模块会隐藏所有的实现细节,把它的 API 与它的实现清晰地隔离开来。模块之间只通过它们的 API 进行通信,一个模块不需要知道其他模块的内部工作情况,这个概念被称为信息隐藏或封装。因此访问权限应当尽可能地使每个类或者成员不被外界访问。
如果子类的方法重写了父类的方法,那么子类中该方法的访问级别不允许低于父类的访问级别。这是为了确保可以使用父类实例的地方都可以使用子类实例去代替,也就是确保满足里氏替换原则。
字段决不能是公有的,因为这么做的话就失去了对这个字段修改行为的控制,客户端可以对其随意修改。例如下面的例子中,AccessExample 拥有 id 公有字段,如果在某个时刻,我们想要使用 int 存储 id 字段,那么就需要修改所有的客户端代码。
public class AccessExample {
    public String id;
}
可以使用公有的 getter 和 setter 方法来替换公有字段,这样的话就可以控制对字段的修改行为。
public class AccessExample {

    private int id;

    public String getId() {
        return id + "";
    }

    public void setId(String id) {
        this.id = Integer.valueOf(id);
    }
}
但是也有例外,如果是包级私有的类或者私有的嵌套类,那么直接暴露成员不会有特别大的影响。
public class AccessWithInnerClassExample {

    private class InnerClass {
        int x;
    }

    private InnerClass innerClass;

    public AccessWithInnerClassExample() {
        innerClass = new InnerClass();
    }

    public int getValue() {
        return innerClass.x;  // 直接访问
    }
}抽象类与接口#
1. 抽象类#
- 抽象类和抽象方法都使用 abstract 关键字进行声明
- 抽象方法仅有声明,不能有方法体,抽象方法必须在非抽象的子类中覆盖(具体实现)
- 抽象类中可以没有任何抽象方法,若一个类中包含抽象方法,那么这个类必须声明为抽象类
- 抽象类不能被实例化,只能被继承
public abstract class AbstractClassExample {

    protected int x;
    private int y;

    public abstract void func1();

    public void func2() {
        System.out.println("func2");
    }
}
public class AbstractExtendClassExample extends AbstractClassExample {
@Override
public void func1() {
System.out.println("func1");
}
}// AbstractClassExample ac1 = new AbstractClassExample(); // 'AbstractClassExample' is abstract; cannot be instantiated
AbstractClassExample ac2 = new AbstractExtendClassExample();
ac2.func1();2. 接口#
- 接口本身默认为包权限,可声明为
public - 接口的成员(方法、域/字段)默认都是 public 的,并且不允许定义为 private 或者 protected
- 接口的域/字段默认都是 static 和 final 的
- 接口的内部类默认是 static(嵌套类)的,且是可继承的
- 接口的方法默认是
abstract的,不能有方法体 - 用
default声明的接口方法可以有默认方法体
接口是抽象类的延伸,从 Java 8 开始,接口也可以拥有默认的方法实现,这是因为不支持默认方法的接口的维护成本太高了(在 Java 8 之前,它可以看成是一个完全抽象的类,也就是说它不能有任何的方法实现,如果一个接口想要添加新的方法,那么要修改所有实现了该接口的类,让它们都实现新增的方法。)
// 成员变量只能是 public static final 的
public static final String name = "张三";
String name = "张三";

// 方法总是 public abstract 的
public abstract List<String> getUserNames(Long companyId);
List<String> getUserNames(Long companyId);
public interface InterfaceExample {
void func1();
default void func2(){
System.out.println("func2");
}
int x = 123;
// int y; // Variable 'y' might not have been initialized
public int z = 0; // Modifier 'public' is redundant for interface fields
// private int k = 0; // Modifier 'private' not allowed here
// protected int l = 0; // Modifier 'protected' not allowed here
// private void fun3(); // Modifier 'private' not allowed here
}public class InterfaceImplementExample implements InterfaceExample {
@Override
public void func1() {
System.out.println("func1");
}
}// InterfaceExample ie1 = new InterfaceExample(); // 'InterfaceExample' is abstract; cannot be instantiated
InterfaceExample ie2 = new InterfaceImplementExample();
ie2.func1();
System.out.println(InterfaceExample.x);3. 比较#
- 从设计层面上看,抽象类提供了一种 IS-A 关系,需要满足里式替换原则,即子类对象必须能够替换掉所有父类对象。而接口更像是一种 LIKE-A 关系,它只是提供一种方法实现契约,并不要求接口和实现接口的类具有 IS-A 关系。
- 从使用上来看,一个类可以实现多个接口,但是不能继承多个抽象类。
- 接口的字段只能是 static 和 final 类型的,而抽象类的字段没有这种限制。
- 接口的成员只能是 public 的,而抽象类的成员可以有多种访问权限。
4. 使用选择#
使用接口:
- 需要让不相关的类都实现一个方法,例如不相关的类都可以实现 Compareable 接口中的 compareTo() 方法;
- 需要使用多重继承。
使用抽象类:
- 需要在几个相关的类中共享代码。
- 需要能控制继承来的成员的访问权限,而不是都为 public。
- 需要继承非静态和非常量字段。
在很多情况下,接口优先于抽象类。因为接口没有抽象类严格的类层次结构要求,可以灵活地为一个类添加行为。并且从 Java 8 开始,接口也可以有默认的方法实现,使得修改接口的成本也变的很低。
内部类(nested class)#
嵌套类(静态内部类)、嵌套接口、多重继承、闭包、回调 (外部类$内部类.class)
非静态内部类(成员内部类)#
非静态内部类必须寄存在一个外部类对象里。因此,如果有一个非静态内部类对象那么一定存在对应的外部类对象。非静态内部类对象单独属于外部类的某个对象。
编译为 Outer$Inner.class
非静态内部类 的 非静态实例 隐式包含对外部类的引用
this$0,使用Outer.this访问外部类对象public class Main { public static void main(String[] args) { Outer outer = new Outer("Nested"); // 实例化一个Outer Outer.Inner inner = outer.new Inner(); // 实例化一个Inner inner.hello(); } } class Outer { private String name; Outer(String name) { this.name = name; } class Inner { void hello() { name += ", call from inner!"; // 可访问外部类私有域 System.out.println("Hello, " + Outer.this.name); // 可访问外部类的实例 } } }非静态内部类可以直接访问外部类的成员,但是外部类不能直接访问非静态内部类成员。
非静态内部类不能有静态方法、静态属性和静态初始化块。
外部类的静态方法、静态代码块不能访问非静态内部类,包括不能使用非静态内部类定义变量、创建实例。
静态内部类#
用static修饰的内部类和Inner Class有很大的不同,它不再依附于Outer的实例,而是一个完全独立的类,因此无法引用Outer.this,但它可以访问Outer的private静态字段和静态方法。如果把StaticNested移到Outer之外,就失去了访问private的权限。编译为 Outer$Inner.class
public class Main {
    public static void main(String[] args) {
        Outer.StaticNested sn = new Outer.StaticNested();
        sn.hello();
    }
}

class Outer {
    private static String NAME = "OUTER";

    private String name;

    Outer(String name) {
        this.name = name;
    }

    static class StaticNested {
        void hello() {
            System.out.println("Hello, " + Outer.NAME);
        }
    }
}匿名内部类#
适合那种只需要使用一次的类,匿名类被编译为Outer$1.class
public class Main {
    public static void main(String[] args) {
        Outer outer = new Outer("Nested");
        outer.asyncHello();
    }
}

class Outer {
    private String name;

    Outer(String name) {
        this.name = name;
    }

    void asyncHello() {
        Runnable r = new Runnable() {
            @Override
            public void run() {
                System.out.println("Hello, " + Outer.this.name);  // 匿名内部类引用外部类实例
            }
        };
        new Thread(r).start();
    }
}局部内部类#
定义在方法内部的,作用域只限于本方法,称为局部内部类。编译为 Outer$1Inner.class
package com.qf.demo1;
/*
 * 局部内部类
 * 1.相当于方法里的局部变量,只能在方法中使用
 *
 */
public class Test {

    public static void main(String[] args) {
        Test();//局部内部类是随着方法的调用而被执行
    }
    public static void Test()
    {
        int a  =4;
        //局部内部类
        //inner 局部内部类 不能添加访问权限修饰符
        class Inner
        {
            private int age;
            private String name;
            public void eat()
            {
                System.out.print("吃");
            }
        }
        //局部内部类只能在声明这个内部类的方法中创建对象
        Inner inner = new Inner();
        inner.eat();
        System.out.println(inner.name);
    }
}super#
- 访问父类的构造函数:可以使用 super() 函数访问父类的构造函数,从而委托父类完成一些初始化的工作。应该注意到,子类一定会调用父类的构造函数来完成初始化工作,一般是调用父类的默认构造函数,如果子类需要调用父类其它构造函数,那么就可以使用 super() 函数。
- 访问父类的成员:如果子类重写了父类的某个方法,可以通过使用 super 关键字来引用父类的方法实现。
public class SuperExample {

    protected int x;
    protected int y;

    public SuperExample(int x, int y) {
        this.x = x;
        this.y = y;
    }

    public void func() {
        System.out.println("SuperExample.func()");
    }
}
public class SuperExtendExample extends SuperExample {
private int z;
public SuperExtendExample(int x, int y, int z) {
super(x, y);
this.z = z;
}
@Override
public void func() {
super.func();
System.out.println("SuperExtendExample.func()");
}
}SuperExample e = new SuperExtendExample(1, 2, 3);
e.func();SuperExample.func()
SuperExtendExample.func()重写与重载#
1. 重写(Override)
存在于继承体系中,指子类实现了一个与父类在方法声明上完全相同的一个方法。
为了满足里式替换原则,重写需要符合下面的三个要点:
“==”: 方法名、形参列表相同(方法签名相同)。
“≤”:返回值类型和声明异常类型,子类小于等于父类。
“≥”: 访问权限,子类大于等于父类。
使用 @Override 注解,可以让编译器帮忙检查是否满足上面的三个限制条件。
下面的示例中,SubClass 为 SuperClass 的子类,SubClass 重写了 SuperClass 的 func() 方法。其中:
- 子类方法访问权限为 public,大于父类的 protected。
- 子类的返回类型为 ArrayList
,是父类返回类型 List 的子类。 - 子类抛出的异常类型为 Exception,是父类抛出异常 Throwable 的子类。
- 子类重写方法使用 @Override 注解,从而让编译器自动检查是否满足限制条件。
class SuperClass {
    protected List<Integer> func() throws Throwable {
        return new ArrayList<>();
    }
}

class SubClass extends SuperClass {
    @Override
    public ArrayList<Integer> func() throws Exception {
        return new ArrayList<>();
    }
}
在调用一个方法时,先从本类中查找看是否有对应的方法,如果没有再到父类中查看,看是否从父类继承来。否则就要对参数进行转型,转成父类之后看是否有对应的方法。总的来说,方法调用的优先级为:
- this.func(this)
- super.func(this)
- this.func(super)
- super.func(super)
/*
    A
    |
    B
    |
    C
    |
    D
 */


class A {

    public void show(A obj) {
        System.out.println("A.show(A)");
    }

    public void show(C obj) {
        System.out.println("A.show(C)");
    }
}

class B extends A {

    @Override
    public void show(A obj) {
        System.out.println("B.show(A)");
    }
}

class C extends B {
}

class D extends C {
}
public static void main(String[] args) {
A a = new A();
B b = new B();
C c = new C();
D d = new D();
// 在 A 中存在 show(A obj),直接调用
a.show(a); // A.show(A)
// 在 A 中不存在 show(B obj),将 B 转型成其父类 A
a.show(b); // A.show(A)
// 在 B 中存在从 A 继承来的 show(C obj),直接调用
b.show(c); // A.show(C)
// 在 B 中不存在 show(D obj),但是存在从 A 继承来的 show(C obj),将 D 转型成其父类 C
b.show(d); // A.show(C)
// 引用的还是 B 对象,所以 ba 和 b 的调用结果一样
A ba = new B();
ba.show(c); // A.show(C)
ba.show(d); // A.show(C)
}2. 重载(Overload)
存在于同一个类中,指一个方法与已经存在的方法名称上相同,但是参数类型、个数、顺序至少有一个不同。应该注意的是,返回值不同,其它都相同不算是重载。
七、反射#
Class对象#
运行时类型信息的表示
每个类都有一个Class对象,包含了与类有关的信息。当编译一个新类时,会产生一个同名的 .class 文件,该文件内容保存着 Class 对象。
类加载相当于 Class 对象的加载,类在第一次使用时(程序创建第一个对类的静态成员的引用时)才动态加载到 JVM 中。也可以使用
Class.forName("com.mysql.jdbc.Driver")这种方式来控制类的加载,该方法会返回一个 Class 对象。- 加载:类加载器查找字节码(.class文件),读取并创建一个Class对象(注意:访问编译期常量、类字面常量不会引起类链接,即惰性初始化)
- 链接:验证字节码,为静态域分配存储空间
- 初始化:若有父类,对其初始化;执行静态初始化器与静态初始化块

RTTI与反射#
运行时识别类和对象信息:
- RTTI(Run-Time Type Identification):编译器编译时打开和检查.class文件,编译时已经知道所有的类型,可以查询引用所指对象的确切类型
(type):传统的类型转换,由RTTI确保正确性,若错误,抛出ClassCastException异常Class对象:包含对象的类型信息instanceof:查看对象是否是某特定类的实例
- 反射:.class文件编译时不可获取,运行时打开和检查.calss文件,可以提供运行时的类信息。
Class 和 java.lang.reflect 一起对反射提供了支持,java.lang.reflect 类库主要包含了以下三个类:
- Field :
class.getField(),可以使用 get() 和 set() 方法读取和修改 Field 对象关联的字段; - Method :
class.getMethod(),可以使用 invoke() 方法调用与 Method 对象关联的方法; - Constructor :
class.Constructor(),可以用 Constructor 的 newInstance() 创建新的对象。
- Field :
反射的优点:
- 可扩展性:应用程序可以利用全限定名创建可扩展对象的实例,来使用来自外部的用户自定义类。
- 类浏览器和可视化开发环境:一个类浏览器需要可以枚举类的成员。可视化开发环境(如 IDE)可以从利用反射中可用的类型信息中受益,以帮助程序员编写正确的代码。
- 调试器和测试工具: 调试器需要能够检查一个类里的私有成员。测试工具可以利用反射来自动地调用类里定义的可被发现的 API 定义,以确保一组测试中有较高的代码覆盖率。
反射的缺点:
尽管反射非常强大,但也不能滥用。如果一个功能可以不用反射完成,那么最好就不用。在我们使用反射技术时,下面几条内容应该牢记于心。
性能开销:反射涉及了动态类型的解析,所以 JVM 无法对这些代码进行优化。因此,反射操作的效率要比那些非反射操作低得多。我们应该避免在经常被执行的代码或对性能要求很高的程序中使用反射。
安全限制:使用反射技术要求程序必须在一个没有安全限制的环境中运行。如果一个程序必须在有安全限制的环境中运行,如 Applet,那么这就是个问题了。
内部暴露:由于反射允许代码执行一些在正常情况下不被允许的操作(比如访问私有的属性和方法),所以使用反射可能会导致意料之外的副作用,这可能导致代码功能失调并破坏可移植性。反射代码破坏了抽象性,因此当平台发生改变的时候,代码的行为就有可能也随着变化。
八、异常#
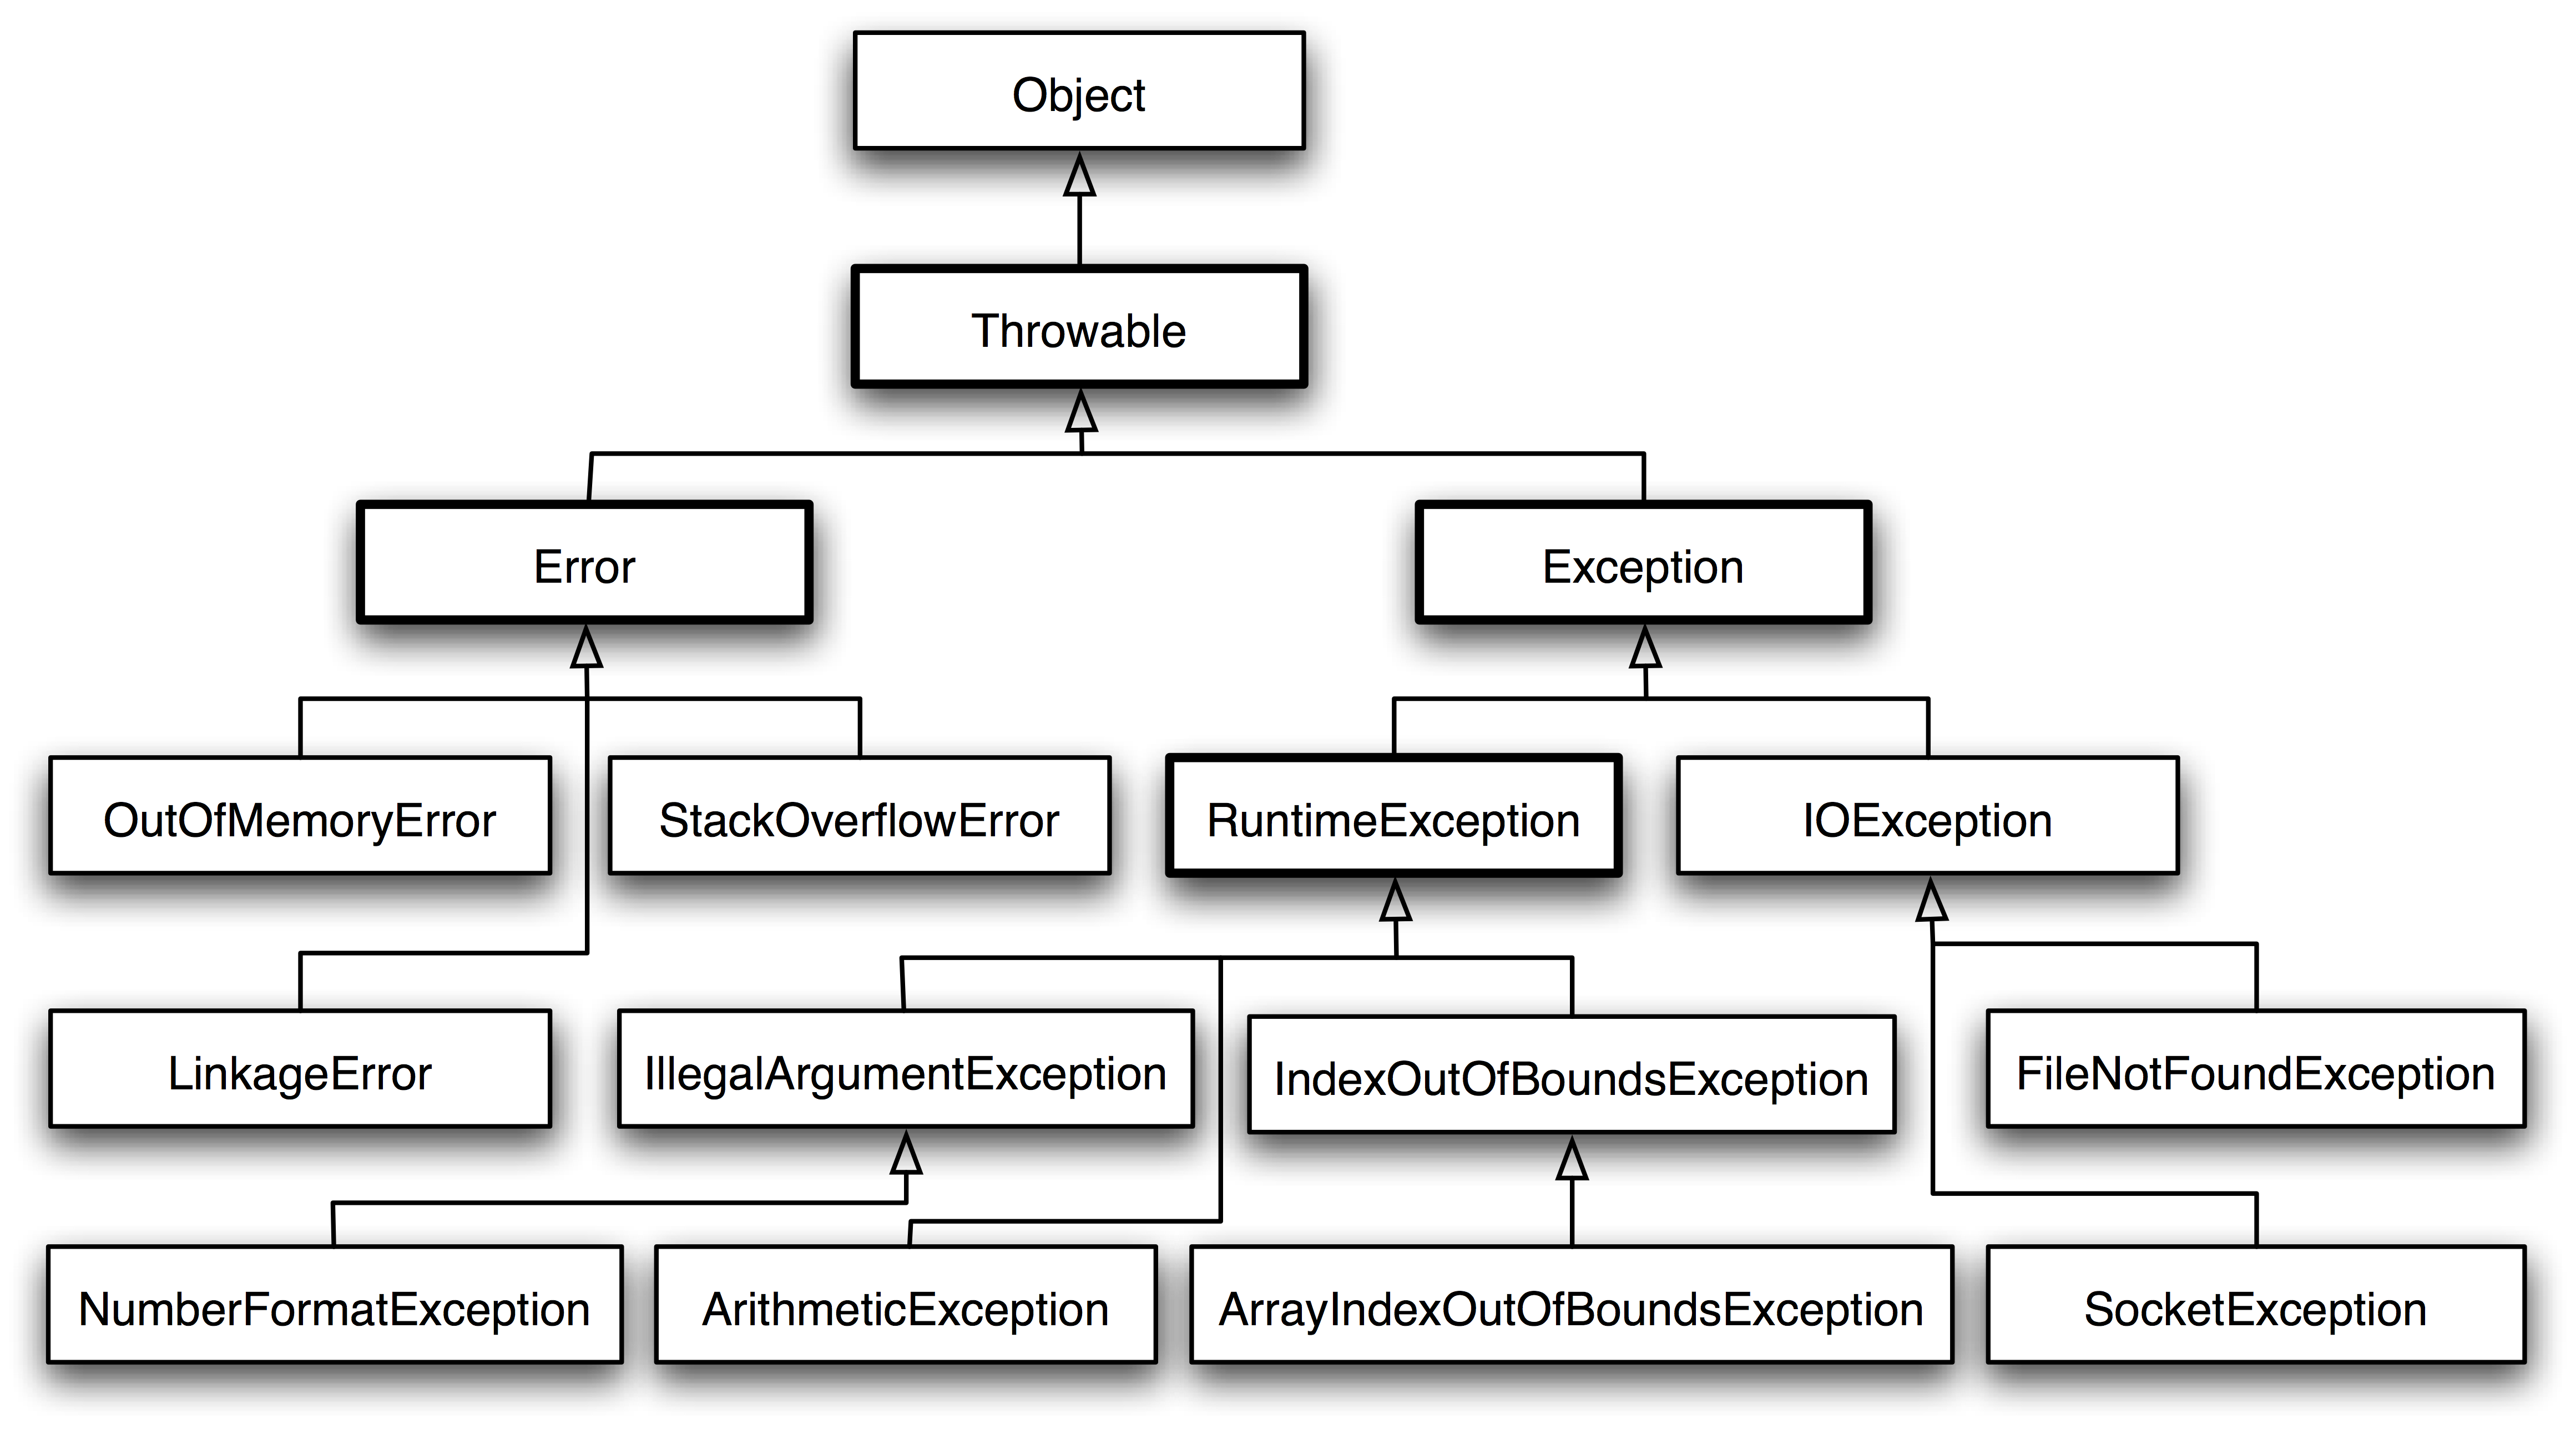
Throwable 可以用来表示任何可以作为异常抛出的类,分为两种: Error 和 Exception。其中 Error 用来表示 JVM 无法处理的错误,Exception 分为两种:
- 受检异常 :需要用 try…catch… 语句捕获并进行处理,并且可以从异常中恢复;
- 非受检异常 :是程序运行时错误(RuntimeException),例如除 0 会引发 Arithmetic Exception,此时程序崩溃并且无法恢复。
九、泛型#
泛型(generics)字面意义为泛化的类型,即参数化类型。
泛型类#
- 泛型的类型参数只能是类类型,不能是简单类型。
- 不能对确切的泛型类型使用instanceof操作。
//此处T可以随便写为任意标识,常见的如T、E、K、V等形式的参数常用于表示泛型
//在实例化泛型类时,必须指定T的具体类型
public class Box<T> {
    // key这个成员变量的类型为T,T的类型在实例化时指定
    private T key;
    public void set(T key) { this.key = key; }
    public T get() { return key; }
}泛型接口#
泛型接口与泛型类的定义及使用基本相同,常被用在各种类的生成器中
//定义一个泛型接口
public interface Generator<T> {
    public T next();
}

/**当实现泛型接口的类,未传入泛型实参时,在声明类的时候需将泛型的声明也一起加到类中:
 * 即:class FruitGenerator<T> implements Generator<T>{
 * 如果不声明泛型,如:class FruitGenerator implements Generator<T>,编译器会报错:"Unknown class"
 */
class FruitGenerator<T> implements Generator<T>{
    @Override
    public T next() {
      	return null;
    }
}

/**当实现泛型接口的类,传入泛型实参时,则所有使用泛型的地方都要替换成传入的实参类型
 * 即:Generator<T>,public T next();中的的T都要替换成传入的String类型。
 */
public class FruitGenerator implements Generator<String> {

    private String[] fruits = new String[]{"Apple", "Banana", "Pear"};

    @Override
    public String next() {
        Random rand = new Random();
        return fruits[rand.nextInt(3)];
    }
}泛型方法#
定义泛型方法的规则如下:
- 所有泛型方法声明都有一个类型参数声明部分(由尖括号分隔),该类型参数声明部分在方法返回类型之前(在下面例子中的
)。 - 每一个类型参数声明部分包含一个或多个类型参数,参数间用逗号隔开。一个泛型参数,也被称为一个类型变量,是用于指定一个泛型类型名称的标识符。
- 类型参数能被用来声明返回值类型,并且能作为泛型方法得到的实际参数类型的占位符。
- 泛型方法体的声明和其他方法一样。注意类型参数 只能代表引用型类型,不能是原始类型 (像 int,double,char 的等)。
public class GenericMethodTest
{
    // 泛型方法 printArray
    public static < E > void printArray( E[] inputArray ){
        // 输出数组元素
        for ( E element : inputArray ){
           System.out.printf( "%s ", element );
        }
        System.out.println();
    }

    /*泛型方法与可变参数
    * args实质是T[]类型的数组
    */
    public <T> void printMsg( T... args){
        for(T t : args){
			System.out.println("泛型测试" + "t is " + t.getClass() + "\t" + t);
        }
	}


	public static void main( String args[] ){
	    // 创建不同类型数组: Integer, Double 和 Character
	    Integer[] intArray = { 1, 2, 3, 4, 5 };
	    Double[] doubleArray = { 1.1, 2.2, 3.3, 4.4 };
	    Character[] charArray = { 'H', 'E', 'L', 'L', 'O'};

	    System.out.println( "整型数组元素为:" );
	    printArray( intArray  ); // 传递一个整型

	    System.out.println( "\n双精度型数组元素为:" );
	    printArray( doubleArray ); // 传递一个双精度型

	    System.out.println( "\n字符型数组元素为:" );
	    printArray( charArray ); // 传递一个字符型数组

        printMsg("111",222,"aaaa","2323.4",55.55);  // 实际传入java.io.Serializable类型数组
	}
}泛型数组#
在java中不能创建一个确切的泛型类型的数组,使用通配符创建泛型数组是可以的。
// 不能创建一个确切的泛型类型的数组
// List<String>[] ls = new ArrayList<String>[10];

// 使用通配符创建泛型数组是可以的
List<?>[] ls = new ArrayList<?>[10];

// raw use 也是可以的
List<String>[] ls = new ArrayList[10];  // 这种有类型检查遗漏风险问题
List[] ls = new ArrayList[10];

public class GenericTest {
	public static void main(String[] args) throws Exception {
		List<String>[] ls = new List[2];

		List<Object> l = new LinkedList<>();
		l.add(new Object());
//		ls[0] = l;  // 类型检查不通过

        // 绕过了类型检查
		Object[] obgList = (Object[])ls;
		obgList[0] = l;
		obgList[1] = new ArrayList<Integer>();

        /*
        * class [Ljava.util.List;
        * 泛型测试t is class java.util.LinkedList	[java.lang.Object@2a84aee7]
        * 泛型测试t is class java.util.ArrayList	[]
        */
		printMsg(obgList);
	}
}泛型通配符与上下界#
- 类型通配符一般是使用
?代替具体的类型参数。例如List<?>在逻辑上是List<String>,List<Integer>等所有 List<具体类型实参> 的父类。 - 类型通配符上限通过形如 List<? extends Number> 来定义,如此定义就是通配符泛型值接受 Number 及其下层子类类型。
- 类型通配符下限通过形如 List<? super Number> 来定义,表示类型只能接受 Number 及其父类类型,如 Objec 类型的实例。
public class GenericsAndCovariance {
    public static void main(String[] args) {
        /* 限定上界的不允许写入 */
        List<? extends Fruit> flist = new ArrayList<Apple>();
        // Compile Error: can’t add any type of object:
        // flist.add(new Apple());
        // flist.add(new Fruit());
        // flist.add(new Object());
        flist.add(null); // Legal but uninteresting
        // We know that it returns at least Fruit:
        Fruit f = flist.get(0);
    }

    /* 限定下界的可写入下届及其子类 */
    static void writeTo(List<? super Apple> apples) {
        apples.add(new Apple());
        apples.add(new Jonathan());
        // apples.add(new Fruit()); // Error
    }
}泛型擦除#
**泛型只在编译阶段有效,泛型类型在逻辑上看以看成是多个不同的类型,实际上都是相同的基本类型。***在泛型代码内部,无法获得任何有关泛型参数类型的信息*
通过上面的例子可以证明,在编译之后程序会采取去泛型化的措施。也就是说Java中的泛型,只在编译阶段有效。在编译过程中,正确检验泛型结果后,会将泛型的相关信息擦出,并且在对象进入和离开方法的边界处添加类型检查和类型转换的方法。也就是说,泛型信息不会进入到运行时阶段。
public class ErasedTypeEquivalence {
    public static void main(String[] args) {
        Class c1 = new ArrayList<String>().getClass();
        Class c2 = new ArrayList<Integer>().getClass();
        System.out.println(c1 == c2);  // true
    }
}

// 在泛型代码内部,无法获得任何有关泛型参数类型的信息,运行时参数T实质为Object类型
// 利用java的RTTI运行时类型信息与反射,可以解决这个问题,不过使用时要显式传入Class参数
public class HasF {
    public void f() { System.out.println("HasF.f()"); }
}
class Manipulator<T> {
    private T obj;
    public Manipulator(T x) { obj = x; }
    // Error: cannot find symbol: method f():
    public void manipulate() { obj.f(); }
}
public class Manipulation {
    public static void main(String[] args) {
        HasF hf = new HasF();
        Manipulator<HasF> manipulator =
        new Manipulator<HasF>(hf);
        manipulator.manipulate();
    }
} 十、注解#
- Java 注解是附加在代码中的一些元信息,用于一些工具在编译、运行时进行解析和使用,起到说明、配置的功能。
- 注解不会也不能影响代码的实际逻辑,仅仅起到辅助性的作用。编译器对其生成与不带注解的代码相同的虚拟机指令。
用法#
- 编译检查:
@SuppressWarnings, @Deprecated与@Override - 在反射中使用Annotation:测试、日志、事务等代码自动生成
- 附属文件自动生成:
@Documented
语法#
声明用法:包、类、接口 | 方法、成员、局部变量、参数变量、类型参数
类型用法java
惯用法:注意注解位置应由注解接口指定
private @NonNull String text; // Annotates the type use
@Id private String userId; // Annotates the variable
public User getUser(@NonNull String userId) // userId 被注解了,同时其参数类型为 @NonNull String
每一个注解必须通过一个注解接口进行定义
@Retention(RetentionPolicy.RUNTIME) public @interface BugReport { // 继承自java.lang.annotation.Annotation enum Status {UNCONFIRMED, CONFIRMED, FIXED, NOTABUG}; boolean showStopper() default false; String assignedTo() default "[none]"; Class<?> testCase() default Void.class; Status status() default Status.UNCONFIRMED; // 参数由编译器计算而来,默认值应为编译期常量,且不为null Reference ref() default @Reference(); // an annotation type,注意不要引入循环依赖 String[] reportedBy(); // 数组赋值需要加{}: `reportBy={"charles", "Cheung"}` }- 标记注解
@Test适用于注解无元素或者都有默认值 - 单值注解
@SingleValue("name")适用于仅有一个元素的注解
- 标记注解
元注解#
| 元注解 | 作用 |
|---|---|
| Target | 描述注解的使用范围(即被修饰的注解可以用在什么地方) |
| Reteniton | 描述注解保留的时间范围(即:被描述的注解在它所修饰的类中可以被保留到何时) |
| Documented | 描述在使用 javadoc 工具为类生成帮助文档时是否要保留其注解信息。 |
| Inherited | 使被它修饰的注解具有继承性(如果某个类使用了被@Inherited修饰的注解,则其子类将自动具有该注解) |
| Repeatable | 允许在同一申明类型(类,属性,或方法)前多次使用同一个类型注解 |
public enum ElementType {
    TYPE,            // 类、接口、枚举类
    FIELD,           // 成员变量(包括:枚举常量)
    METHOD,          // 成员方法
    PARAMETER,       // 方法参数
    CONSTRUCTOR,     // 构造方法
    LOCAL_VARIABLE,  // 局部变量
    ANNOTATION_TYPE, // 注解类
    PACKAGE,         // 可用于修饰:包
    TYPE_PARAMETER,  // 变量注解:类型参数,JDK 1.8 新增,表示该注解能写在类型参数的声明语句中
    TYPE_USE         // 类型注解:使用类型的任何地方,JDK 1.8 新增
}
public enum RetentionPolicy {
SOURCE, // 源文件保留,如 @Override 和 @SuppressWarnings,不包含在class文件中
CLASS, // 编译期保留,默认值,包含在class文件中,但不加载进虚拟机
RUNTIME // 运行期保留,可通过反射去获取注解信息
}标准注解#
| 注解 | 作用域 | 作用 |
|---|---|---|
| Deprecated | 方法 | 对已过时的方法发出警告 |
| SuppressedWarnings | 阻止特定类型的警告信息 | |
| Override | 方法 | 检查方法是否真正覆盖超类的方法 |
| Generated | 所有 | 代码生成使用,用以区分与程序员编写代码 |
| PostConstruct | 方法 | 控制对象生命周期:对象构建后调用 |
| PreDestroy | 方法 | 控制对象生命周期:对象销毁前调用 |
| Resource | 类、接口、方法、域 | 资源注入 |
字节码工程#
asm 修改类文件#
加载时修改字节码#

Java Annotation认知(包括框架图、详细介绍、示例说明)
十一、Lambda表达式与Stream API#
编程思想:
- 面向过程编程
- 面向对象编程
- 函数式编程
- 面向切面编程
- 面向消息编程
1. Lambda 表达式#
Lambda 表达式是一个匿名函数,即没有函数名的函数,可以表示闭包。Lambda 表达式简化了匿名内部类的形式,但其实内部的实现原理却不相同:匿名内部类在编译之后会创建一个新的匿名内部类出来,而 Lambda 被编译器封装为主类的一个private static 方法,然后调用 JVM
invokedynamic指令实现的,并不会产生新类。其使用有两个条件:
- 必须有相应的函数接口(函数接口是指内部只有一个抽象方法的接口,通常使用
@FunctionalInterface标注) - 类型推断机制:在上下文信息足够的情况下,编译器可以推断出参数表的类型,而不需要显式指名
2. Lambda 写法#
Runnable run = () -> System.out.println("Hello World");// 1 无参数
ActionListener listener = event -> System.out.println("button clicked");// 2 单参数
BinaryOperator<Long> add = (Long x, Long y) -> x + y;// 3 多参数
BinaryOperator<Long> addImplicit = (x, y) -> x + y;// 4 多参数的类型推断
Runnable multiLine = () -> {// 5 代码块
    System.out.print("Hello");
    System.out.println(" Hoolee");
};

// 与匿名内部类对比
new Thread(new Runnable(){// 接口名
	@Override
	public void run(){// 方法名
		System.out.println("Thread run()");
	}
}).start();

new Thread(
		() -> System.out.println("Thread run()") // 省略接口名和方法名
).start();
3. 方法引用与构造器引用#
方法引用可以将一个方法赋给一个变量或者作为参数传递给另外一个方法,甚至将方法作为一个函数式接口的实例。
诸如
String::length的语法形式叫做方法引用(method references),这种语法用来替代某些特定形式Lambda表达式。如果Lambda表达式的全部内容就是调用一个已有的方法,那么可以用方法引用来替代Lambda表达式。方法引用可以细分为四类:
| 方法引用类别 | 举例 |
|---|---|
| 引用静态方法 | Integer::sum |
| 引用某个对象的方法 | list::add |
| 引用某个类的方法 | String::length |
| 引用构造方法 | HashMap::new |
// 引用方法的参数个数、类型,返回值类型要和函数式接口中的方法声明一一对应才行
Comparator<Integer> comparator = Integer::compare;
int result = comparator.compare(100,10);

IntBinaryOperator intBinaryOperator = Integer::compare;
int result = intBinaryOperator.applyAsInt(10,100);

// 构造器引用
Integer::new
4. Stream#
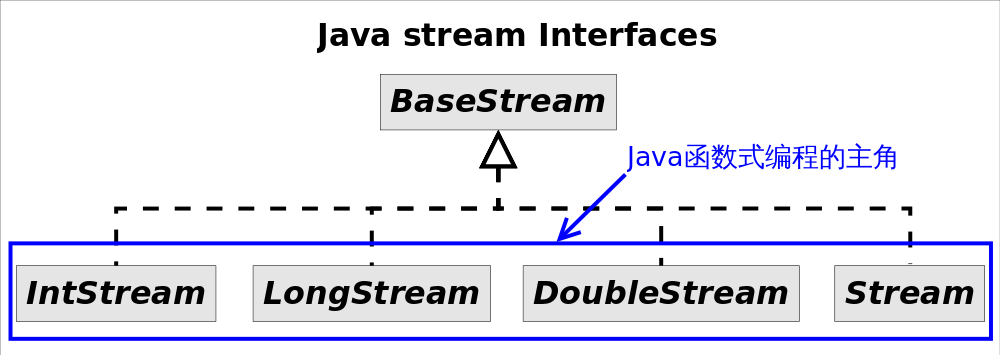
BaseStream接口包括四个继承接口,其中IntStream, LongStream, DoubleStream对应三种基本类型(int, long, double,注意不是包装类型),Stream对应所有剩余类型的stream视图。为不同数据类型设置不同stream接口,可以
- 提高性能
- 增加特定接口函数。
大部分情况下stream是容器调用Collection.stream()方法得到的,但stream和collections有以下不同:
- 无存储。stream不是一种数据结构,它只是某种数据源的一个视图,数据源可以是一个数组,Java容器或I/O channel等。
- 为函数式编程而生。对stream的任何修改都不会修改背后的数据源,比如对stream执行过滤操作并不会删除被过滤的元素,而是会产生一个不包含被过滤元素的新stream。
- 惰式执行。stream上的操作并不会立即执行,只有等到用户真正需要结果的时候才会执行。
- 可消费性。stream只能被“消费”一次,一旦遍历过就会失效,就像容器的迭代器那样,想要再次遍历必须重新生成。
5. Stream API#
对stream的操作分为两类,可以通过方法的返回值进行区分,即返回值为stream的大都是中间操作,否则是结束操作。
- 中间操作(intermediate operations):总是会惰式执行,调用中间操作只会生成一个标记了该操作的新stream,仅此而已。
- 结束操作(terminal operations):会触发实际计算,计算发生时会把所有中间操作积攒的操作以pipeline的方式执行,这样可以减少迭代次数。计算完成之后stream就会失效。
| 操作类型 | 接口方法 |
|---|---|
| 中间操作 | concat() distinct() filter() flatMap() limit() map() peek() skip() sorted() parallel() sequential() unordered() |
| 结束操作 | allMatch() anyMatch() collect() count() findAny() findFirst() forEach() forEachOrdered() max() min() noneMatch() reduce() toArray() |
规约操作(reduction operation)又被称作折叠操作(fold),是通过某个连接动作将所有元素汇总成一个汇总结果的过程。元素求和、求最大值或最小值、求出元素总个数、将所有元素转换成一个列表或集合,都属于规约操作。Stream类库有两个通用的规约操作
reduce()和collect()
6. Reduce详解#
reduce操作可以实现从一组元素中生成一个值,sum()、max()、min()、count()等都是reduce操作,将他们单独设为函数只是因为常用。reduce()的方法定义有三种重写形式:
Optional<T> reduce(BinaryOperator<T> accumulator)
T reduce(T identity, BinaryOperator<T> accumulator)
<U> U reduce(U identity, BiFunction<U,? super T,U> accumulator, BinaryOperator<U> combiner)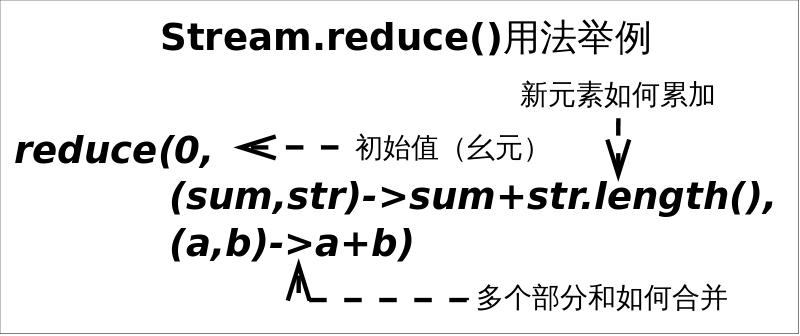
虽然函数定义越来越长,但语义不曾改变,多的参数只是为了指明初始值(参数identity),或者是指定并行执行时多个部分结果的合并方式(参数combiner)。reduce()最常用的场景就是从一堆值中生成一个值。用这么复杂的函数去求一个最大或最小值,你是不是觉得设计者有病。其实不然,因为“大”和“小”或者“求和”有时会有不同的语义。
// 求单词长度之和
Stream<String> stream = Stream.of("I", "love", "you", "too");
Integer lengthSum = stream.reduce(0, // 初始值 // (1)
        (sum, str) -> sum+str.length(), // 累加器 // (2)
        (a, b) -> a+b); // 部分和拼接器,并行执行时才会用到 // (3)
// int lengthSum = stream.mapToInt(str -> str.length()).sum();
System.out.println(lengthSum);
7. Collect详解#
collect()是Stream接口方法中最灵活的一个,如果某个功能在Stream接口中没找到,十有八九可以通过collect()方法实现,其方法签名为:
<R> R collect(Supplier<R> supplier, BiConsumer<R,? super T> accumulator, BiConsumer<R,R> combiner)
<R,A> R collect(Collector<? super T,A,R> collector)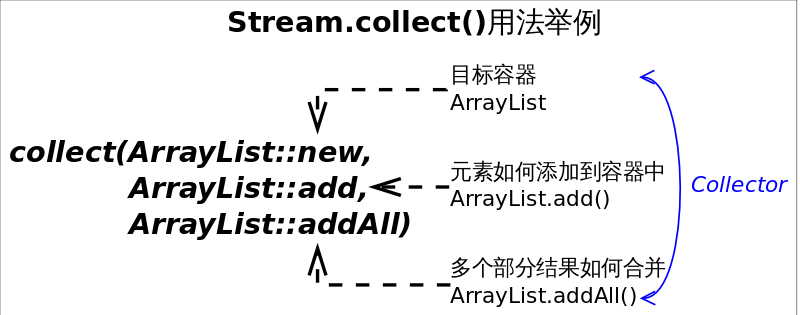
收集器(Collector)是为Stream.collect()方法量身打造的工具接口(类)。考虑一下将一个Stream转换成一个容器(或者Map)需要做哪些工作?我们至少需要:
- 目标容器是什么?是*
ArrayList还是HashSet,或者是个TreeMap*。 - 新元素如何添加到容器中?是
List.add()还是Map.put()。 - 如果并行的进行规约,还需要告诉
collect()如何将多个部分结果合并成一个。
通常情况下我们不需要手动指定collect()的三个参数,而是调用collect(Collector<? super T,A,R> collector)方法,并且参数中的Collector对象大都是直接通过Collectors工具类获得。实际上传入的收集器的行为决定了collect()的行为。
Stream<String> stream = Stream.of("I", "love", "you", "too");
List<String> list = stream.collect(ArrayList::new, ArrayList::add, ArrayList::addAll); // (0)

// 使用Collector
List<String> list = stream.collect(Collectors.toList()); // (1)
Set<String> set = stream.collect(Collectors.toSet()); // (2)

// 使用toCollection()指定规约容器的类型
ArrayList<String> arrayList = stream.collect(Collectors.toCollection(ArrayList::new));// (3)
HashSet<String> hashSet = stream.collect(Collectors.toCollection(HashSet::new));// (4)Stream背后依赖于某种数据源,数据源可以是数组、容器等,但不能是Map。反过来从*Stream生成Map是可以的,但我们要想清楚Map的key和value分别代表什么,根本原因是我们要想清楚要干什么。通常在三种情况下collect()的结果会是Map*:
- 使用
Collectors.toMap()生成的收集器,用户需要指定如何生成Map的key和value。 - 使用
Collectors.partitioningBy()生成的收集器,对元素进行二分区操作时用到。 - 使用
Collectors.groupingBy()生成的收集器,对元素做group操作时用到。
// 使用toMap()统计学生GPA
Map<Student, Double> studentToGPA =
     students.stream().collect(Collectors.toMap(Function.identity(),// 如何生成key
                                     student -> computeGPA(student)));// 如何生成value

// Partition students into passing and failing
Map<Boolean, List<Student>> passingFailing = students.stream()
         .collect(Collectors.partitioningBy(s -> s.getGrade() >= PASS_THRESHOLD));

// Group employees by department
Map<Department, List<Employee>> byDept = employees.stream()
            .collect(Collectors.groupingBy(Employee::getDepartment)); // 根据部门分组

// 使用下游收集器统计每个部门的人数
Map<Department, Integer> totalByDept = employees.stream()
                    .collect(Collectors.groupingBy(Employee::getDepartment,
                                                   Collectors.counting()));// 下游收集器,count聚合

// 按照部门对员工分布组,并只保留员工的名字
Map<Department, List<String>> byDept = employees.stream()
                .collect(Collectors.groupingBy(Employee::getDepartment,
                        Collectors.mapping(Employee::getName,// 下游收集器
Collectors.toList())));// 更下游的收集器字符串拼接时使用Collectors.joining()生成的收集器,从此告别for循环。Collectors.joining()方法有三种重写形式,分别对应三种不同的拼接方式。
// 使用Collectors.joining()拼接字符串
Stream<String> stream = Stream.of("I", "love", "you");
//String joined = stream.collect(Collectors.joining()); // "Iloveyou"
//String joined = stream.collect(Collectors.joining(",")); // "I,love,you"
String joined = stream.collect(Collectors.joining(",", "{", "}")); // "{I,love,you}"

String joined = stream.collect(StringBuilder::new, (s1, s2) -> { // "{I,love,you}"
			if (StringUtils.isEmpty(s1)) {
				s1.append(s2);
			} else {
				s1.append(',').append(s2);
			}
		}, StringBuilder::append).append('}').insert(0, '{').toString();
8. Stream Pipelines原理#
直观的讲,为每一次函数调用都执一次迭代一定能够实现功能,但效率上肯定是无法接受的:
- 迭代次数多。迭代次数跟函数调用的次数相等。
- 频繁产生中间结果。每次函数调用都产生一次中间结果,存储开销无法接受。
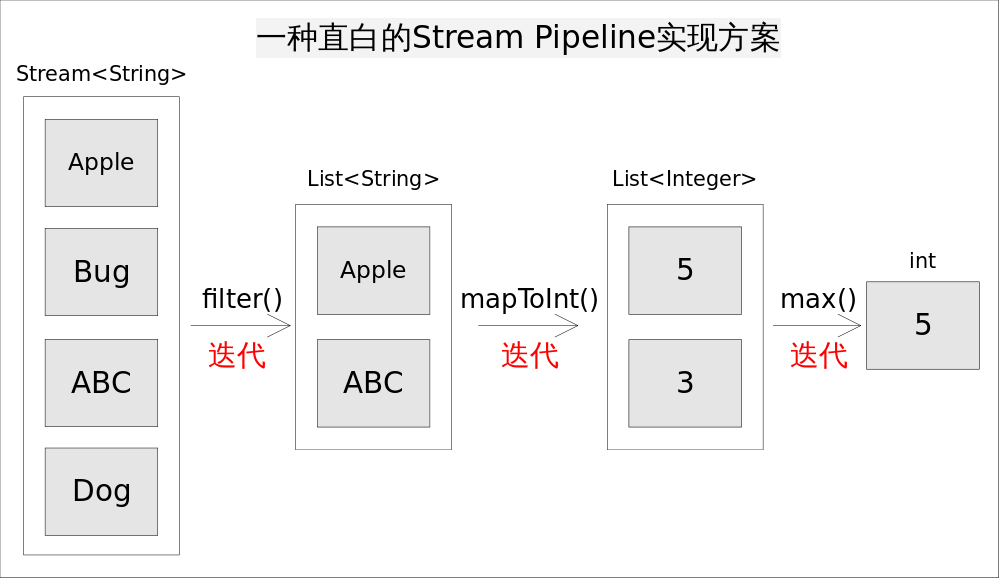
Stream类库的实现着使用流水线(Pipeline)的方式巧妙的避免了多次迭代,其基本思想是在一次迭代中尽可能多的执行用户指定的操作,具体来讲其将操作分为两类:中间操作和结束操作
- 中间操作只是一种标记,在遇到结束操作之前只是把中间操作记录了下来。中间操作可以分为无状态的(Stateless)和有状态的(Stateful):
- 无状态中间操作是指元素的处理不受前面元素的影响。
- 有状态的中间操作必须等到所有元素处理之后才知道最终结果,比如排序是有状态操作,在读取所有元素之前并不能确定排序结果;
- 结束操作会触发实际计算,可以分为短路操作和非短路操作:
- 短路操作是指不用处理全部元素就可以返回结果,比如找到第一个满足条件的元素。
- 非短路操作必须处理完所有元素才能返回结果。
| Stream操作 | 分类 | |
|---|---|---|
| 中间操作(Intermediate operations) | 无状态(Stateless) | unordered() filter() map() mapToInt() mapToLong() mapToDouble() flatMap() flatMapToInt() flatMapToLong() flatMapToDouble() peek() |
| 有状态(Stateful) | distinct() sorted() sorted() limit() skip() | |
| 结束操作(Terminal operations) | 短路操作(short-circuiting) | anyMatch() allMatch() noneMatch() findFirst() findAny() |
| 非短路操作 | forEach() forEachOrdered() toArray() reduce() collect() max() min() count() |
之所以要进行如此精细的划分,是因为底层对每一种情况的处理方式不同,具体来讲,有以下几个问题:
- 用户的操作如何记录?
- 操作如何叠加?
- 叠加之后的操作如何执行?
- 执行后的结果(如果有)在哪里?
1. 操作如何记录?#
注意这里使用的是“操作(operation)”一词,指的是“Stream中间操作”的操作,很多Stream操作会需要一个回调函数(Lambda表达式),因此一个完整的操作是**<数据源,操作,回调函数>**构成的三元组。Stream中使用Stage的概念来描述一个完整的操作,并用某种实例化后的PipelineHelper来代表Stage,将具有先后顺序的各个Stage连到一起,就构成了整个流水线。跟Stream相关类和接口的继承关系图示。
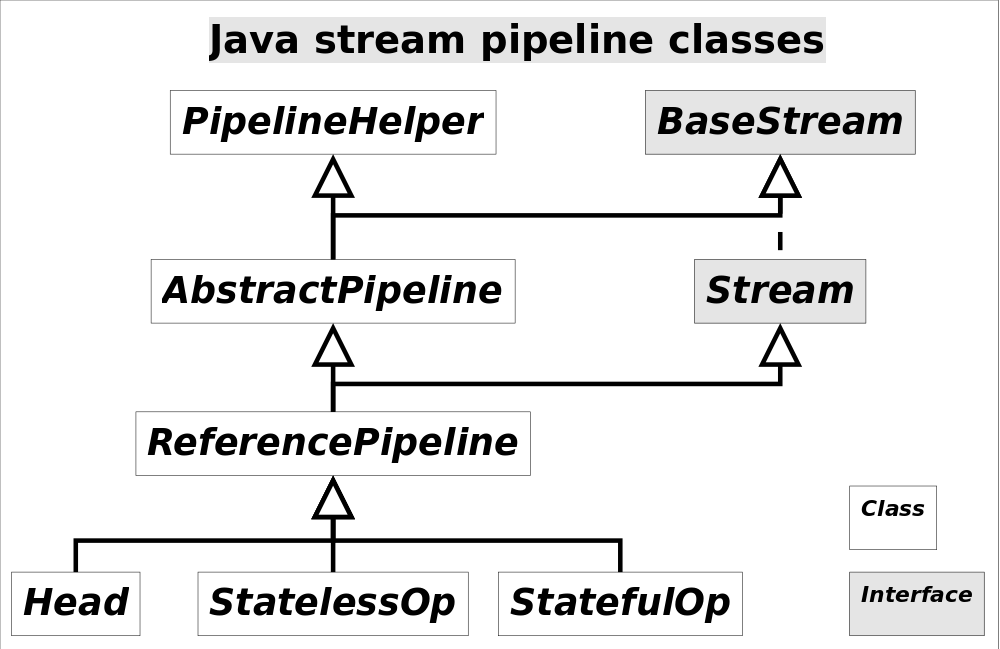
还有IntPipeline, LongPipeline, DoublePipeline没在图中画出,这三个类专门为三种基本类型(不是包装类型)而定制的,跟ReferencePipeline是并列关系。
图中Head用于表示第一个Stage,即调用诸如Collection.stream()方法产生的Stage,很显然这个Stage里不包含任何操作;StatelessOp和StatefulOp分别表示无状态和有状态的Stage,对应于无状态和有状态的中间操作。Stream流水线组织结构示意图如下:
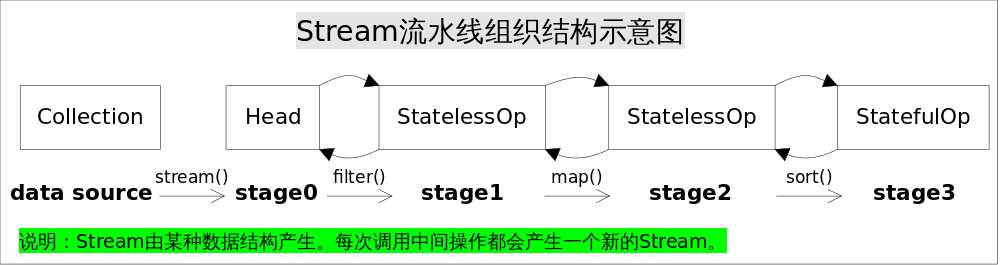
图中通过Collection.stream()方法得到Head也就是stage0,紧接着调用一系列的中间操作,不断产生新的Stream。这些Stream对象以双向链表的形式组织在一起,构成整个流水线,由于每个Stage都记录了前一个Stage和本次的操作以及回调函数,依靠这种结构就能建立起对数据源的所有操作。这就是Stream记录操作的方式。
2. 操作如何叠加?#
以上只是解决了操作记录的问题,要想让流水线起到应有的作用我们需要一种将所有操作叠加到一起的方案。你可能会觉得这很简单,只需要从流水线的head开始依次执行每一步的操作(包括回调函数)就行了。这听起来似乎是可行的,但是你忽略了前面的Stage并不知道后面Stage到底执行了哪种操作,以及回调函数是哪种形式。换句话说,只有当前Stage本身才知道该如何执行自己包含的动作。这就需要有某种协议来协调相邻Stage之间的调用关系。
这种协议由Sink接口完成,Sink接口包含的方法如下表所示:
| 方法名 | 作用 |
|---|---|
| void begin(long size) | 开始遍历元素之前调用该方法,通知Sink做好准备。 |
| void end() | 所有元素遍历完成之后调用,通知Sink没有更多的元素了。 |
| boolean cancellationRequested() | 是否可以结束操作,可以让短路操作尽早结束。 |
| void accept(T t) | 遍历元素时调用,接受一个待处理元素,并对元素进行处理。Stage把自己包含的操作和回调方法封装到该方法里,前一个Stage只需要调用当前Stage.accept(T t)方法就行了。 |
有了上面的协议,相邻Stage之间调用就很方便了,每个Stage都会将自己的操作封装到一个Sink里,前一个Stage只需调用后一个Stage的accept()方法即可,并不需要知道其内部是如何处理的。Sink的四个接口方法常常相互协作,共同完成计算任务。实际上Stream API内部实现的的本质,就是如何重载Sink的这四个接口方法。
- 对于有状态的操作,Sink的
begin()和end()方法也是必须实现的。比如Stream.sorted()是一个有状态的中间操作,其对应的Sink.begin()方法可能创建一个存放结果的容器,而accept()方法负责将元素添加到该容器,最后end()负责对容器进行排序。 - 对于短路操作,
Sink.cancellationRequested()也是必须实现的,比如Stream.findFirst()是短路操作,只要找到一个元素,cancellationRequested()就应该返回true,以便调用者尽快结束查找。
有了Sink对操作的包装,Stage之间的调用问题就解决了,执行时只需要从流水线的head开始对数据源依次调用每个Stage对应的Sink.{begin(), accept(), cancellationRequested(), end()}方法就可以了。一种可能的Sink.accept()方法流程是这样的:
void accept(U u){
    1. 使用当前Sink包装的回调函数处理u
    2. 将处理结果传递给流水线下游的Sink
}
Sink接口的其他几个方法也是按照这种[处理->转发]的模型实现。下面我们结合具体例子看看Stream的中间操作是如何将自身的操作包装成Sink以及Sink是如何将处理结果转发给下一个Sink的。先看Stream.map()方法:
// Stream.map(),调用该方法将产生一个新的Stream
public final <R> Stream<R> map(Function<? super P_OUT, ? extends R> mapper) {
    ...
    return new StatelessOp<P_OUT, R>(this, StreamShape.REFERENCE,
                                 StreamOpFlag.NOT_SORTED | StreamOpFlag.NOT_DISTINCT) {
        @Override /*opWripSink()方法返回由回调函数包装而成Sink*/
        Sink<P_OUT> opWrapSink(int flags, Sink<R> downstream) {
            return new Sink.ChainedReference<P_OUT, R>(downstream) {
                @Override
                public void accept(P_OUT u) {
                    R r = mapper.apply(u);// 1. 使用当前Sink包装的回调函数mapper处理u
                    downstream.accept(r);// 2. 将处理结果传递给流水线下游的Sink
                }
            };
        }
    };
}上述代码看似复杂,其实逻辑很简单,就是将回调函数mapper包装到一个Sink当中。由于Stream.map()是一个无状态的中间操作,所以map()方法返回了一个StatelessOp内部类对象(一个新的Stream),调用这个新Stream的opWripSink()方法将得到一个包装了当前回调函数的Sink。
再来看一个复杂一点的例子。Stream.sorted()方法将对Stream中的元素进行排序,显然这是一个有状态的中间操作,因为读取所有元素之前是没法得到最终顺序的。抛开模板代码直接进入问题本质,sorted()方法是如何将操作封装成Sink的呢?sorted()一种可能封装的Sink代码如下:
// Stream.sort()方法用到的Sink实现
class RefSortingSink<T> extends AbstractRefSortingSink<T> {
    private ArrayList<T> list;// 存放用于排序的元素
    RefSortingSink(Sink<? super T> downstream, Comparator<? super T> comparator) {
        super(downstream, comparator);
    }

    @Override
    public void begin(long size) {
        ...
        // 创建一个存放排序元素的列表
        list = (size >= 0) ? new ArrayList<T>((int) size) : new ArrayList<T>();
    }

    @Override
    public void end() {
        list.sort(comparator);// 只有元素全部接收之后才能开始排序
        downstream.begin(list.size());
        if (!cancellationWasRequested) {// 下游Sink不包含短路操作
            list.forEach(downstream::accept);// 2. 将处理结果传递给流水线下游的Sink
        }
        else {// 下游Sink包含短路操作
            for (T t : list) {// 每次都调用cancellationRequested()询问是否可以结束处理。
                if (downstream.cancellationRequested()) break;
                downstream.accept(t);// 2. 将处理结果传递给流水线下游的Sink
            }
        }
        downstream.end();
        list = null;
    }

    @Override
    public void accept(T t) {
        list.add(t);// 1. 使用当前Sink包装动作处理t,只是简单的将元素添加到中间列表当中
    }
}
上述代码完美的展现了Sink的四个接口方法是如何协同工作的:
- 首先beging()方法告诉Sink参与排序的元素个数,方便确定中间结果容器的的大小;
- 之后通过accept()方法将元素添加到中间结果当中,最终执行时调用者会不断调用该方法,直到遍历所有元素;
- 最后end()方法告诉Sink所有元素遍历完毕,启动排序步骤,排序完成后将结果传递给下游的Sink;
- 如果下游的Sink是短路操作,将结果传递给下游时不断询问下游cancellationRequested()是否可以结束处理。
3. 叠加之后的操作如何执行?#
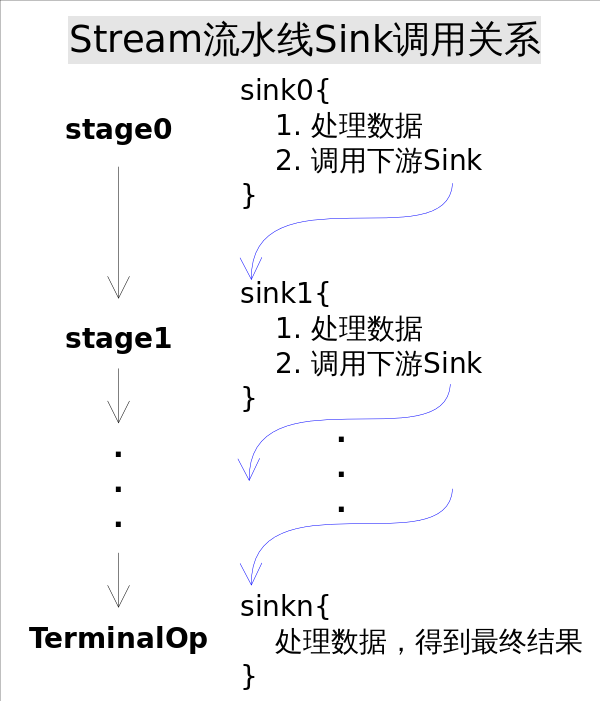
Sink完美封装了Stream每一步操作,并给出了[处理->转发]的模式来叠加操作。这一连串的齿轮已经咬合,就差最后一步拨动齿轮启动执行。是什么启动这一连串的操作呢?也许你已经想到了启动的原始动力就是结束操作(Terminal Operation),一旦调用某个结束操作,就会触发整个流水线的执行。
结束操作之后不能再有别的操作,所以结束操作不会创建新的流水线阶段(Stage),直观的说就是流水线的链表不会在往后延伸了。结束操作会创建一个包装了自己操作的Sink,这也是流水线中最后一个Sink,这个Sink只需要处理数据而不需要将结果传递给下游的Sink(因为没有下游)。对于Sink的[处理->转发]模型,结束操作的Sink就是调用链的出口。
我们再来考察一下上游的Sink是如何找到下游Sink的。一种可选的方案是在PipelineHelper中设置一个Sink字段,在流水线中找到下游Stage并访问Sink字段即可。但Stream类库的设计者没有这么做,而是设置了一个Sink AbstractPipeline.opWrapSink(int flags, Sink downstream)方法来得到Sink,该方法的作用是返回一个新的包含了当前Stage代表的操作以及能够将结果传递给downstream的Sink对象。为什么要产生一个新对象而不是返回一个Sink字段?这是因为使用opWrapSink()可以将当前操作与下游Sink(上文中的downstream参数)结合成新Sink。试想只要从流水线的最后一个Stage开始,不断调用上一个Stage的opWrapSink()方法直到最开始(不包括stage0,因为stage0代表数据源,不包含操作),就可以得到一个代表了流水线上所有操作的Sink,用代码表示就是这样:
// AbstractPipeline.wrapSink()
// 从下游向上游不断包装Sink。如果最初传入的sink代表结束操作,
// 函数返回时就可以得到一个代表了流水线上所有操作的Sink。
final <P_IN> Sink<P_IN> wrapSink(Sink<E_OUT> sink) {
    ...
    for (AbstractPipeline p=AbstractPipeline.this; p.depth > 0; p=p.previousStage) {
        sink = p.opWrapSink(p.previousStage.combinedFlags, sink);
    }
    return (Sink<P_IN>) sink;
}
现在流水线上从开始到结束的所有的操作都被包装到了一个Sink里,执行这个Sink就相当于执行整个流水线,执行Sink的代码如下:
// AbstractPipeline.copyInto(), 对spliterator代表的数据执行wrappedSink代表的操作。
final <P_IN> void copyInto(Sink<P_IN> wrappedSink, Spliterator<P_IN> spliterator) {
    ...
    if (!StreamOpFlag.SHORT_CIRCUIT.isKnown(getStreamAndOpFlags())) {
        wrappedSink.begin(spliterator.getExactSizeIfKnown());// 通知开始遍历
        spliterator.forEachRemaining(wrappedSink);// 迭代
        wrappedSink.end();// 通知遍历结束
    }
    ...
}上述代码首先调用wrappedSink.begin()方法告诉Sink数据即将到来,然后调用spliterator.forEachRemaining()方法对数据进行迭代(Spliterator是容器的一种迭代器,[参阅](https://github.com/CarpenterLee/JavaLambdaInternals/blob/master/3-Lambda and Collections.md#spliterator)),最后调用wrappedSink.end()方法通知Sink数据处理结束。逻辑如此清晰。
4. 执行后的结果在哪里?#
最后一个问题是流水线上所有操作都执行后,用户所需要的结果(如果有)在哪里?首先要说明的是不是所有的Stream结束操作都需要返回结果,有些操作只是为了使用其副作用(Side-effects),比如使用Stream.forEach()方法将结果打印出来就是常见的使用副作用的场景(事实上,除了打印之外其他场景都应避免使用副作用),对于真正需要返回结果的结束操作结果存在哪里呢?
特别说明:副作用不应该被滥用,也许你会觉得在Stream.forEach()里进行元素收集是个不错的选择,就像下面代码中那样,但遗憾的是这样使用的正确性和效率都无法保证,因为Stream可能会并行执行。大多数使用副作用的地方都可以使用归约操作更安全和有效的完成。
// 错误的收集方式
ArrayList<String> results = new ArrayList<>();
stream.filter(s -> pattern.matcher(s).matches())
      .forEach(s -> results.add(s));  // Unnecessary use of side-effects!

// 正确的收集方式
List<String>results =
     stream.filter(s -> pattern.matcher(s).matches())
             .collect(Collectors.toList());  // No side-effects!
回到流水线执行结果的问题上来,需要返回结果的流水线结果存在哪里呢?这要分不同的情况讨论,下表给出了各种有返回结果的Stream结束操作。
| 返回类型 | 对应的结束操作 |
|---|---|
| boolean | anyMatch() allMatch() noneMatch() |
| Optional | findFirst() findAny() |
| 归约结果 | reduce() collect() |
| 数组 | toArray() |
- 对于表中返回boolean或者Optional的操作(Optional是存放一个值的容器)的操作,由于返回一个值,只需要在对应的Sink中记录这个值,等到执行结束时返回就可以了。
- 对于归约操作,最终结果放在用户调用时指定的容器中(容器类型通过[收集器](https://objcoding.com/2019/03/04/lambda/5-Streams API(II).md#收集器)指定)。collect(), reduce(), max(), min()都是归约操作,虽然max()和min()也是返回一个Optional,但事实上底层是通过调用[reduce()](https://objcoding.com/2019/03/04/lambda/5-Streams API(II).md#多面手reduce)方法实现的。
- 对于返回是数组的情况,毫无疑问的结果会放在数组当中。这么说当然是对的,但在最终返回数组之前,结果其实是存储在一种叫做Node的数据结构中的。Node是一种多叉树结构,元素存储在树的叶子当中,并且一个叶子节点可以存放多个元素。这样做是为了并行执行方便。关于Node的具体结构,我们会在下一节探究Stream如何并行执行时给出详细说明。
本文详细介绍了Stream流水线的组织方式和执行过程,学习本文将有助于理解原理并写出正确的Stream代码,同时打消你对Stream API效率方面的顾虑。如你所见,Stream API实现如此巧妙,即使我们使用外部迭代手动编写等价代码,也未必更加高效。
9. parallelStream#
Fork/Join 框架的核心是采用分治法的思想,将一个大任务拆分为若干互不依赖的子任务,把这些子任务分别放到不同的队列里,并为每个队列创建一个单独的线程来执行队列里的任务。同时,为了最大限度地提高并行处理能力,采用了工作窃取算法来运行任务,也就是说当某个线程处理完自己工作队列中的任务后,尝试当其他线程的工作队列中窃取一个任务来执行,直到所有任务处理完毕。所以为了减少线程之间的竞争,通常会使用双端队列,被窃取任务线程永远从双端队列的头部拿任务执行,而窃取任务的线程永远从双端队列的尾部拿任务执行。
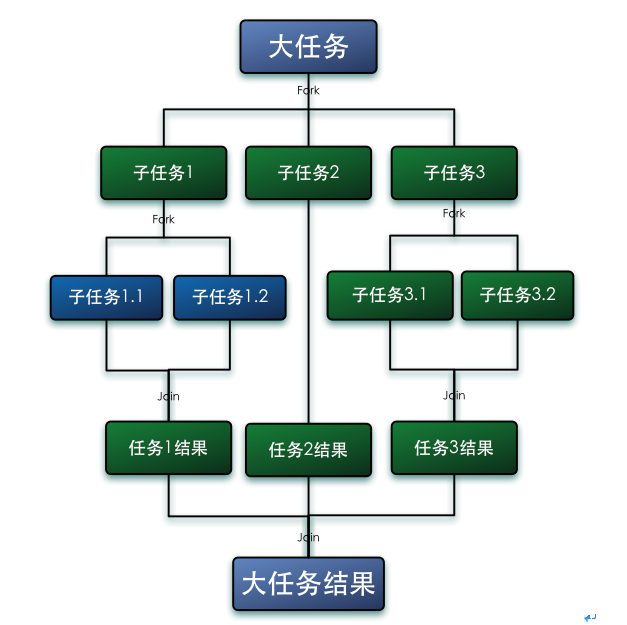
使用parallelStream的几个好处:
- 代码优雅,可以使用lambda表达式,原本几句代码现在一句可以搞定;
- 运用多核特性(forkAndJoin)并行处理,大幅提高效率。 关于并行流和多线程的性能测试可以看一下下面的几篇博客: 并行流适用场景-CPU密集型 提交订单性能优化系列之006-普通的Thread多线程改为Java8的parallelStream并发流
然而,任何事物都不是完美的,并行流也不例外,其中最明显的就是使用(parallel)Stream极其不便于代码的跟踪调试,此外并行流带来的不确定性也使得我们对它的使用变得格外谨慎。我们得去了解更多的并行流的相关知识来保证自己能够正确的使用这把双刃剑。
parallelStream使用时需要注意的点:
- 适用CPU密集型的计算任务,不适用于IO密集型,特别的,对于CPU负载很大的情况也不适用。
- 不要在多线程中使用parallelStream,原因同上类似,大家都抢着CPU是没有提升效果,反而还会加大线程切换开销。
- 确保每条处理无状态且没有关联
- 使用并行流的时候是无法保证元素的顺序的
十三、特性#
Java 各版本的新特性#
New highlights in Java SE 8
- Lambda Expressions
- Pipelines and Streams
- Date and Time API
- Default Methods
- Type Annotations
- Nashhorn JavaScript Engine
- Concurrent Accumulators
- Parallel operations
- PermGen Error Removed
New highlights in Java SE 7
- Strings in Switch Statement
- Type Inference for Generic Instance Creation
- Multiple Exception Handling
- Support for Dynamic Languages
- Try with Resources
- Java nio Package
- Binary Literals, Underscore in literals
- Diamond Syntax
Java 与 C++ 的区别#
- Java 是纯粹的面向对象语言,所有的对象都继承自 java.lang.Object,C++ 为了兼容 C 即支持面向对象也支持面向过程。
- Java 通过虚拟机从而实现跨平台特性,但是 C++ 依赖于特定的平台。
- Java 没有指针,它的引用可以理解为安全指针,而 C++ 具有和 C 一样的指针。
- Java 支持自动垃圾回收,而 C++ 需要手动回收。
- Java 不支持多重继承,只能通过实现多个接口来达到相同目的,而 C++ 支持多重继承。
- Java 不支持操作符重载,虽然可以对两个 String 对象执行加法运算,但是这是语言内置支持的操作,不属于操作符重载,而 C++ 可以。
- Java 的 goto 是保留字,但是不可用,C++ 可以使用 goto。
What are the main differences between Java and C++?
JRE or JDK#
- JRE:Java Runtime Environment,java运行环境的简称,为java的运行提供了所需的环境。主要包括了JVM的标准实现和一些java基本类库。
- JDK:Java Development Kit,java开发工具包,提供了java的开发及运行环境。JDK是java开发的核心,集成了JRE以及一些其他的工具,比如编译 java 源码的编译器 javac等。
- 因此可以这样认为:JDK>JRE>JVM,JRE支持了java程序的运行,而JDK则同时支持了java程序的开发。
参考资料#
- Eckel B. Java 编程思想[M]. 机械工业出版社, 2002.
- Bloch J. Effective java[M]. Addison-Wesley Professional, 2017.